介绍
本案例通过 azkaban 执行任务,上传数据到 HDFS 上,调用 hive 客户端执行 SQL 分析数据
由于 hive 客户端只在 hadoop1 上部署,所以这里使用 单机模式
启动hadoop、hive
登录 hadoop1,执行下面命令:
cd /program/bin/
启动hadoop:
./hadoop.sh start
启动hive:
./hive.sh start
启动azkaban单机模式
登录 hadoop1,执行下面命令:
cd /program/azkaban-solo-server-3.81.0/
bin/start-solo.sh
目录树结构
/azkaban/
├── data
│   ├── sogou.500w.utf8.1w
│   └── sogou.txt
├── sogou_job
│   ├── hdfs_hive_table.job
│   ├── hive_count.job
│   ├── hive_current_time.job
│   ├── hive_gjc.job
│   ├── hive_uid.job
│   ├── hive_xw.job
│   └── sogou.zip
└── sogou_sh
    ├── hdfs_upload.sh
    ├── hive_count.sh
    ├── hive_current_time.sh
    ├── hive_gjc.sh
    ├── hive_table.sh
    ├── hive_uid.sh
    └── hive_xw.sh
准备数据
详见 链接
上传
创建目录:
mkdir /azkaban/data -p
上传到 hadoop1 的 /azkaban/data/ 目录
编写脚本
创建目录
创建 /sogou_sh 目录
cd /azkaban
mkdir sogou_sh
cd /azkaban/sogou_sh/
编写上传数据到 HDFS 脚本
创建脚本文件:
vim hdfs_upload.sh
内容如下:
#提示系统该文件为脚本文件
#!/bin/sh
echo "判断目录是否存在"
#判断hdfs上sogou_ext目录是否存在,存在则删除,不存在无操作
hadoop fs -test -e /sogou_ext/
if [ $? -eq 0 ]; then
     echo "目录以存在,执行删除"
     hadoop fs -rmr /sogou_ext/
fi
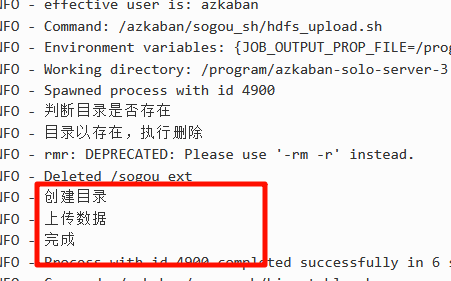
echo "创建目录"
#创建/sogou_ext/20111230目录
hadoop fs -mkdir -p /sogou_ext/20111230
echo "上传数据"
#上传sogou.500w.utf8.1w.flt文件到/sogou_ext/20111230目录中
hadoop fs -put /azkaban/data/sogou.txt /sogou_ext/20111230
echo "完成"
编写 hive 脚本
创建脚本文件:
vim hive_table.sh
内容如下:
#提示系统该文件为脚本文件
#!/bin/sh
echo "删除sogou数据库如果存在"
#删除数据库如果存在
hive -e 'drop database if exists sogou cascade;'
echo "创建sogou数据库"
#创建数据库
hive -e 'create database sogou;'
#创建外部表,并指定hdfs数据存放目录,字段对应sogou.500w.utf8.1w.flt文件中的字段
echo "创建名为'sogou_ext_20111230'外部表"
hive -e 'CREATE EXTERNAL TABLE sogou.sogou_ext_20111230(ts STRING, uid STRING, keyword STRING, rank INT, `order` INT, url STRING, year INT, month INT, day INT, hour INT ) COMMENT "This is the sogou search data of extend data" ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t" STORED AS TEXTFILE LOCATION "/sogou_ext/20111230";'
编写统计总数脚本
创建脚本:
vim hive_count.sh
内容如下:
#提示系统该文件为脚本文件
#!/bin/sh
echo "统计数据总条数"
#统计数据中条数
hive -e 'select count(*) from sogou.sogou_ext_20111230;'
echo "非空查询条数"
#统计非空查询
hive -e 'select count(*) from sogou.sogou_ext_20111230 where keyword is not null and keyword !="";'
echo "无重复总条数(根据ts、uid、keyword、url)"
#无重复总条数
hive -e 'select count(*) from (select ts,uid,keyword,url from sogou.sogou_ext_20111230 group by ts,uid,keyword,url having count(*) =1) a;'
echo "独立UID总数"
#独立UID总数
hive -e 'select count(distinct(uid)) from sogou.sogou_ext_20111230;'
编写统计脚本
vim hive_gjc.sh
文件内容:
#提示系统该文件为脚本文件
#!/bin/sh
echo "查询关键词长度统计"
#查询关键词长度统计
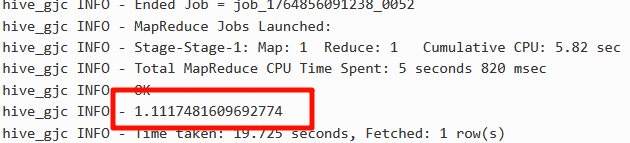
hive -e 'select avg(a.cnt) from (select size(split(keyword, "\\s+")) as cnt from sogou.sogou_ext_20111230) a;'
echo "查询频度排名(频度最高的前50词)"
#查询频度排名(频度最高的前50词)
hive -e 'select keyword,count(*) as cnt from sogou.sogou_ext_20111230 group by keyword order by cnt desc limit 50;'
编写UID分析脚本
vim hive_uid.sh
文件内容:
#提示系统该文件为脚本文件
#!/bin/sh
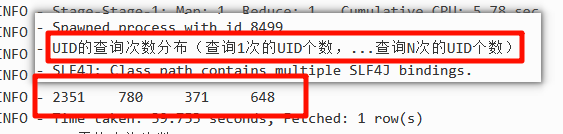
echo "UID的查询次数分布(查询1次的UID个数,...查询N次的UID个数)"
# UID的查询次数分布(查询1次的UID个数,...查询N次的UID个数)
hive -e 'select SUM(IF(uids.cnt=1,1,0)),SUM(IF(uids.cnt=2,1,0)),SUM(IF(uids.cnt=3,1,0)),SUM(IF(uids.cnt>3,1,0)) from(select uid,count(*) as cnt from sogou.sogou_ext_20111230 group by uid) uids;'
echo "UID平均查询次数"
# UID平均查询次数
hive -e 'select sum(a.cnt)/count(a.uid) from (select uid,count(*) as cnt from sogou.sogou_ext_20111230 group by uid) a;'
echo "查询次数大于2次的用户总数"
#查询次数大于2次的用户总数
hive -e 'select count(a.uid) from (select uid,count(*) as cnt from sogou.sogou_ext_20111230 group by uid having cnt > 2) a;'
echo "查询次数大于2次的用户占比"
#查询次数大于2次的用户占比
hive -e 'select b.bnt/c.dnt from(select count(a.uid) bnt from (select uid,count(*) as cnt from sogou.sogou_ext_20111230 group by uid having cnt > 2)a )b,(select count(distinct (uid)) dnt from sogou.sogou_ext_20111230)c;'
echo "查询次数大于2次的数据展示"
#查询次数大于2次的数据展示
hive -e 'select b.* from (select uid,count(*) as cnt from sogou.sogou_ext_20111230 group by uid having cnt > 2) a join sogou.sogou_ext_20111230 b on a.uid=b.uid limit 50;'
编写 用户行为分析 脚本
vim hive_xw.sh
文件内容:
#提示系统该文件为脚本文件
#!/bin/sh
echo "1.点击次数与Rank之间的关系分析"
#1.点击次数与Rank之间的关系分析
hive -e 'Select a.ant/b.bnt from (select count(*) ant from sogou.sogou_ext_20111230 where rank < 11)a,(select count(*) bnt from sogou.sogou_ext_20111230)b;'

echo "2.直接输入URL作为查询词的比例"
echo "(1)直接输入URL作为查询词的比例"
#(1)直接输入URL作为查询词的比例
hive -e 'Select a.ant/b.bnt from (select count(*) ant from sogou.sogou_ext_20111230 where keyword  like "%www%")a,(select count(*) bnt from sogou.sogou_ext_20111230)b;'
echo "(2)直接输入URL的查询中,点击数点击的结果就是用户输入的URL的网址 所占的比例"
#(2)直接输入URL的查询中,点击数点击的结果就是用户输入的URL的网址 所占的比例
hive -e 'Select c.ant/b.bnt from (select SUM(IF(instr(url,keyword)>0,1,0)) ant from (select * from sogou.sogou_ext_20111230 where keyword  like "%www%") a)c,( select count(*) bnt from sogou.sogou_ext_20111230 where keyword  like "%www%")b;'

echo "3.独立用户行为分析"
echo "(1)    查询搜索过”仙剑奇侠传“的uid,并且次数大于3"
#(1)    查询搜索过”仙剑奇侠传“的uid,并且次数大于3
hive -e 'select uid,count(*) as cnt from sogou.sogou_ext_20111230  where keyword="仙剑奇侠传" group by uid having cnt > 3;'
echo "(2)查找uid是653d48aa356d5111ac0e59f9fe736429和e11c6273e337c1d1032229f1b2321a75的相关搜索记录"
#(2)查找uid是653d48aa356d5111ac0e59f9fe736429和e11c6273e337c1d1032229f1b2321a75的相关搜索记录
echo "653d48aa356d5111ac0e59f9fe736429"
hive -e 'select * from sogou.sogou_ext_20111230 where uid="653d48aa356d5111ac0e59f9fe736429" and keyword like "%仙剑奇侠传%";'
echo "e11c6273e337c1d1032229f1b2321a75"
hive -e 'select * from sogou.sogou_ext_20111230 where uid="e11c6273e337c1d1032229f1b2321a75" and keyword like "%仙剑奇侠传%";'
编写uid分析脚本
vim hive_current_time.sh
文件内容:
#提示系统该文件为脚本文件
#!/bin/sh
echo "每个UID在当天的查询点击次数"
echo "(1)创建临时表"
#(1)创建临时表
hive -e 'create table sogou.uid_cnt(uid STRING, cnt INT) COMMENT "This is the sogou search data of one day" ROW FORMAT DELIMITED FIELDS TERMINATED BY "\t" STORED AS TEXTFILE;'

echo "查询并插入"
#查询并插入
hive -e 'INSERT OVERWRITE TABLE sogou.uid_cnt select uid,count(*) as cnt from sogou.sogou_ext_20111230 group by uid;'
给以上脚本授权
chmod +x *.sh
编写 azkaban 任务文件
创建目录
cd /azkaban/
mkdir sogou_job
cd /azkaban/sogou_job/
hdfs_hive_table
vim hdfs_hive_table.job
内容:
type=command
#执行hdfs上传脚本
command=/azkaban/sogou_sh/hdfs_upload.sh
#执行hive创表脚本
command.1=/azkaban/sogou_sh/hive_table.sh
hive_count
vim hive_count.job
内容:
type=command
#执行条数统计脚本
command=/azkaban/sogou_sh/hive_count.sh
#依赖于hdfs_hive_table.job执行
dependencies=hdfs_hive_table
hive_gjc
vim hive_gjc.job
内容:
type=command
#执行关键词分析脚本
command=/azkaban/sogou_sh/hive_gjc.sh
#依赖于hdfs_hive_table.job执行
dependencies=hive_count
hive_uid
vim hive_uid.job
内容:
type=command
#执行UID分析脚本
command=/azkaban/sogou_sh/hive_uid.sh
#依赖于hdfs_hive_table.job执行
dependencies=hive_gjc
hive_xw
vim hive_xw.job
内容:
type=command
#执行用户行为分析脚本
command=/azkaban/sogou_sh/hive_xw.sh
#依赖于hdfs_hive_table.job执行
dependencies=hive_uid
hive_current_time
vim hive_current_time.job
内容:
type=command
#执行实时分析脚本
command=/azkaban/sogou_sh/hive_current_time.sh
#依赖于hdfs_hive_table.job执行
dependencies=hive_xw
将任务文件打包
zip -r sogou.zip hdfs_hive_table.job hive_count.job hive_current_time.job hive_gjc.job hive_uid.job hive_xw.job
azkaban web网页操作
打开浏览器,输入网址: http://hadoop1:8081 敲回车
创建工程

输入项目名、描述,如下图:


执行,如下图:

立即执行,如下图:

执行结果


hdfs_hive_table 执行结果

点击【log】 查看详情,上传成功:
hive_count 执行结果

hive_gjc 执行结果
hive_uid 执行结果
hive_xw 执行结果

hive_current_time 执行结果
