介绍
向量是 线性代数 的基础,也是深度学习(比如大模型的词嵌入、注意力机制)中无处不在的工具。
定义
向量(Vector)是既有大小,又有方向的量,可以简单理解为:
- 数学上:一维有序 数组(比如
[1, 2, 3]); - 几何上:空间中的一条 有向线段(比如从原点指向 (1,2) 的箭头);
- 深度学习中:用来表示特征(如词嵌入向量)、参数(如模型权重)、梯度(如优化时的梯度向量)的基本单元。
与标量区别
标量:只有大小,如 5、3.2,向量的关键是 “有序”—— 顺序不同,向量就不同:
[1, 2]≠[2, 1](几何上是不同方向的箭头)。
数学属性
1. 向量的维度
向量的维度 = 向量中元素的个数,比如:
- 2维向量:
[x, y](平面直角坐标系中的点); - 3维向量:
[x, y, z](空间中的点); - 高维向量:
[a1, a2, ..., an](深度学习中常见,如768维的BERT词嵌入)。
例子
坐标 (x, y) 的含义
- 第一个数 x:在 x 轴方向 走多少步
- 第二个数 y:在 y 轴方向 走多少步
所以:
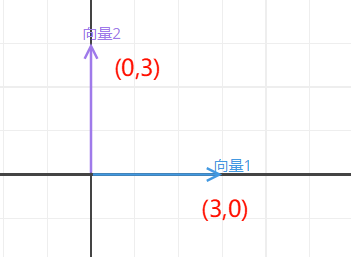
- (3, 0) = 在 x 轴走 3 步,y 轴不走
- (0, 3) = 在 y 轴走 3 步,x 轴不走
如下图:
例子:
- (0.5,0.5)
- (0.7,0.5)
- (-0.6,0.5)

2. 向量的基本运算
| 运算 | 数学定义(以二维向量为例) | 含义 |
|---|---|---|
| 加法 | [x1,y1] + [x2,y2] = [x1+x2, y1+y2] |
几何上:向量首尾相连 |
| 数乘 | k * [x,y] = [k*x, k*y] |
缩放向量长度,k为负数则反向 |
| 点积(内积) | [x1,y1] · [x2,y2] = x1x2 + y1y2 |
结果是标量,衡量向量相似度 |
| 模长(长度) | v = √(x² + y²) |
几何上:向量的长度 |
3. 关键衍生概念
- 单位向量:模长=1的向量(用于表示方向,如
[1,0]是x轴正方向); - 余弦相似度:
cosθ = (v1·v2) / (||v1||×||v2||),衡量两个向量的方向相似度(θ是夹角,值越接近1,方向越一致); - 正交向量:点积=0的两个向量(几何上垂直,如
[1,0]和[0,1])。
PyTorch中的向量
在PyTorch中,向量就是一维张量(1阶张量),下面是核心操作示例:
1. 创建向量(一维张量)
import torch

# 1. 从列表创建向量
v1 = torch.tensor([1.0, 2.0, 3.0])  # 3维向量(一维张量)
v2 = torch.tensor([4.0, 5.0, 6.0])

# 2. 验证向量属性(一维张量)
print("向量v1:", v1)
print("维度数(阶):", v1.ndim)  # 1(向量的核心特征:ndim=1)
print("形状:", v1.shape)        # torch.Size([3])(3维向量)
print("元素个数:", v1.numel())  # 3
2. 向量的基本运算
# 1. 向量加法
v_add = v1 + v2
print("向量加法:", v_add)  # tensor([5., 7., 9.])

# 2. 数乘(缩放)
v_mul = 2 * v1
print("数乘(×2):", v_mul)  # tensor([2., 4., 6.])

# 3. 点积(内积,用torch.dot)
dot_product = torch.dot(v1, v2)
print("点积:", dot_product)  # 1×4 + 2×5 + 3×6 = 32 → tensor(32.)

# 4. 模长(用torch.norm)
norm_v1 = torch.norm(v1)
print("v1模长:", norm_v1)  # √(1²+2²+3²)=√14 ≈3.7417 → tensor(3.7417)

# 5. 余弦相似度
cos_sim = dot_product / (norm_v1 * torch.norm(v2))
print("余弦相似度:", cos_sim)  # ≈0.9744(接近1,说明v1和v2方向高度相似)
3. 向量的常见操作
# 1. 转为单位向量(归一化)
v1_unit = v1 / norm_v1
print("v1单位向量:", v1_unit)
print("单位向量模长:", torch.norm(v1_unit))  # tensor(1.)

# 2. 向量减法
v_sub = v2 - v1
print("向量减法:", v_sub)  # tensor([3., 3., 3.])

# 3. 索引访问向量元素
print("v1第0个元素:", v1[0])  # tensor(1.)
print("v1最后一个元素:", v1[-1])  # tensor(3.)
在深度学习中的应用
向量是深度学习的“基本砖块”,核心场景包括:
1. 词嵌入(Word Embedding)
- 每个单词被表示为一个高维向量(如768维),向量的相似度对应单词的语义相似度;
- 例:“猫”和“狗”的向量余弦相似度高,“猫”和“汽车”的相似度低。
2. 注意力机制
- Query/Key/Value都是向量,注意力打分的核心是Query和Key的点积(衡量匹配度);
- 例:
score = Q · K^T(批量点积),分数越高,越关注对应位置的信息。
3. 模型参数与梯度
- 模型的权重、偏置都是向量/矩阵(高维向量);
- 梯度下降中,梯度是参数的偏导数组成的向量,优化方向是“负梯度方向”。
4. 特征表示
- 图像/文本/语音的特征最终都会被编码为向量,作为模型的输入;
- 例:一张图片经CNN提取特征后,得到一个1024维的特征向量。
注意
- 向量 vs 一维张量:在PyTorch中,向量就是
ndim=1的张量,shape=[n](而非[1,n]或[n,1],这两个是二维张量/矩阵); - 高维向量的直观性:高维向量(如768维)无法几何可视化,但数学运算规则和低维向量完全一致;
- 向量运算的设备一致性:GPU上的向量和CPU上的向量不能直接运算,需用
to(device)统一设备。
总结
- 向量是有大小、有方向的一维有序数组,在PyTorch中对应
ndim=1的张量; - 核心运算:加法、数乘、点积、模长计算,其中点积是衡量向量相似度的关键;
- 深度学习中,向量是词嵌入、特征表示、注意力打分、梯度优化的核心载体;
- 关键衍生概念:单位向量、余弦相似度(大模型中判断语义相似的核心指标)。
掌握向量的基本概念和运算,就能理解深度学习中大部分基础操作的数学本质——比如注意力机制的打分、词嵌入的相似度计算,本质都是向量的点积和余弦相似度。