介绍
torch.stack() 函数,是张量拼接操作中非常重要的一个,核心作用是在指定维度上堆叠多个形状相同的张量,并生成一个新的维度,和普通的拼接(torch.cat)有本质区别。
作用
将一些 形状完全相同 的张量,在指定的 dim 维度上进行“堆叠”,堆叠后会 新增一个维度(维度大小等于张量的数量),最终张量的维度数 = 原张量维度数 + 1
堆叠图解
下面演示 两个二维矩阵的堆叠方式
按照0轴堆叠

按照1轴堆叠
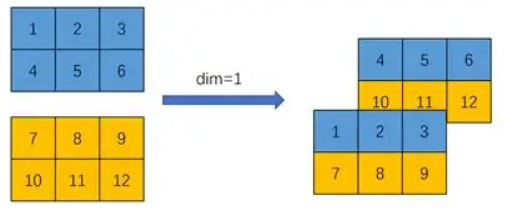
按照2轴堆叠

语法
torch.stack(tensors, dim=0, out=None) → Tensor
形参:
tensors:必选,要堆叠的张量序列(列表/元组 形式),所有张量必须 形状完全相同;dim:可选,指定堆叠的维度位置,默认0,取值范围是[- (原维度数+1), 原维度数](如原张量是2维,dim可取值-3, -2, -1, 0, 1, 2);out:可选,输出张量,一般无需指定。
与 torch.cat 区别
torch.cat 是在 已有维度上拼接(维度数不变),torch.stack 是新增维度堆叠(维度数+1)。
例子
先通过简单例子对比 stack 和 cat,再演示不同 dim 的效果:
import torch

# 准备3个形状相同的张量(2x2)
a = torch.tensor([[1, 2], [3, 4]])
b = torch.tensor([[5, 6], [7, 8]])
c = torch.tensor([[9, 10], [11, 12]])
print("原张量形状:", a.shape)  # 输出:torch.Size([2, 2])
示例1:默认dim=0堆叠(新增第0维)
stack_dim0 = torch.stack([a, b, c], dim=0)
print("\ndim=0堆叠结果形状:", stack_dim0.shape)  # 输出:torch.Size([3, 2, 2])
print("dim=0堆叠结果:")
print(stack_dim0)
# 输出:
# tensor([[[ 1,  2],
#          [ 3,  4]],
#         [[ 5,  6],
#          [ 7,  8]],
#         [[ 9, 10],
#          [11, 12]]])
示例2:dim=1堆叠(新增第1维)
stack_dim1 = torch.stack([a, b, c], dim=1)
print("\ndim=1堆叠结果形状:", stack_dim1.shape)  # 输出:torch.Size([2, 3, 2])
print("dim=1堆叠结果:")
print(stack_dim1)
# 输出:
# tensor([[[ 1,  2],
#          [ 5,  6],
#          [ 9, 10]],
#         [[ 3,  4],
#          [ 7,  8],
#          [11, 12]]])
示例3:dim=2堆叠(新增第2维)
stack_dim2 = torch.stack([a, b, c], dim=2)
print("\ndim=2堆叠结果形状:", stack_dim2.shape)  # 输出:torch.Size([2, 2, 3])
print("dim=2堆叠结果:")
print(stack_dim2)
# 输出:
# tensor([[[ 1,  5,  9],
#          [ 2,  6, 10]],
#         [[ 3,  7, 11],
#          [ 4,  8, 12]]])
对比:torch.cat
在已有维度拼接,维度数不变
cat_dim0 = torch.cat([a, b, c], dim=0)
print("\ntorch.cat dim=0拼接形状:", cat_dim0.shape)  # 输出:torch.Size([6, 2])
使用场景
torch.stack 在实际开发中常用于以下场景:
(1)批量构建数据
将多个单样本张量堆叠成批量张量(新增batch维度):
# 单个样本(特征维度:5)
sample1 = torch.randn(5)
sample2 = torch.randn(5)
sample3 = torch.randn(5)
# 堆叠成batch(batch_size=3, feature_dim=5)
batch = torch.stack([sample1, sample2, sample3], dim=0)
print(batch.shape)  # 输出:torch.Size([3, 5])
(2)合并多维度特征
在深度学习中,将多个同形状的特征张量堆叠,新增维度表示“特征类型”:
# 3个同形状的特征图(height=4, width=4)
feat1 = torch.randn(4, 4)  # 特征1
feat2 = torch.randn(4, 4)  # 特征2
feat3 = torch.randn(4, 4)  # 特征3
# 堆叠成(channel=3, height=4, width=4)的特征图
feat_stack = torch.stack([feat1, feat2, feat3], dim=0)
print(feat_stack.shape)  # 输出:torch.Size([3, 4, 4])
(3)维度重组
配合 unstack 实现张量维度的拆分与重组(反向操作):
# 拆分stack的结果(反向操作)
unstacked = torch.unbind(stack_dim0, dim=0)  # 拆分第0维
print("拆分后的第一个张量:", unstacked[0])  # 输出和a完全一致
注意事项
- 形状必须完全一致:要堆叠的所有张量形状必须相同,否则会报错(如不能堆叠
[2,2]和[3,2]的张量); - dim的取值范围:
dim不能超过“原维度数+1”,比如原张量是2维,dim最大只能取2(新增最后一维); - 与cat的选择:
- 想新增维度 → 用
stack; - 想在已有维度上扩展 → 用
cat。
- 想新增维度 → 用
总结
torch.stack()核心是新增维度堆叠多个同形状张量,堆叠后维度数+1;dim参数控制新增维度的位置,不同dim会改变张量的组织形式;- 常用场景包括批量构建数据、合并多特征张量,需注意与
torch.cat的区别(cat不新增维度)。