介绍
OpenAI公开分享了它们的 GPT-2模型的权重,我们不用在大型语料库上训练模型,可以节省数万到数十万美元。可以将这些 权重 加载到 GPTModel 类中,并使用该模型 进行文本生成。
权重
权重指的是存储在PyTorch的 Linear层 和 Embedding层 的 .weight属性中的权重参数。
TensorFlow
OpenAI最初通过 TensorFlow 保存了GPT-2的权重,所以需要 安装TensorFlow 才能加载这些权重。
TensorFlow 类似 PyTorch,是深度学习开发框架
安装
安装 tqdm
tqdm是进度条工具,显示下载进度
poetry add tqdm
或者
pip install tqdm>=4.66
安装 TensorFlow
poetry add tensorflow>=2.15.0
或者
pip install tensorflow>=2.15.0
下载权重
下载 gpt_download.py
通过 gpt_download.py 文件,才能下载权重,所以需要先下载该文件
注意:需要从 github 下载,由于不可抗拒原因,有时可能会 下载失败
import urllib.request
url = (
    "https://raw.githubusercontent.com/rasbt/"
    "LLMs-from-scratch/main/ch05/"
    "01_main-chapter-code/gpt_download.py"
)
filename = url.split('/')[-1]
urllib.request.urlretrieve(url, filename)
下载权重
可以按如下方式从 gpt_download.py 文件中导入 download_and_load_gpt2() 函数。
第一次执行时,会自动下载权重,共7个文件。
注意:需要从 github 下载,由于不可抗拒原因,有时可能会 下载失败之后执行,自动检测到这7个文件存在,就直接加载 GPT-2架构设置(
settings) 和 权重参数(params)
from gpt_download import download_and_load_gpt2
settings, params = download_and_load_gpt2(
    model_size="124M", models_dir="gpt2"
)
第一次执行如下,下载7个文件:
checkpoint: 100%|█████████████████████████████| 77.0/77.0 [00:00<00:00,
                                                         63.9kiB/s]
encoder.json: 100%|███████████████████████████| 1.04M/1.04M [00:00<00:00,
                                                           2.20MiB/s]
hprams.json: 100%|████████████████████████████| 90.0/90.0 [00:00<00:00,
                                                         78.3kiB/s]
model.ckpt.data-00000-of-00001: 100%|███████| 498M/498M [01:09<00:00,
                                                         7.16MiB/s]
model.ckpt.index: 100%|██████████████████████| 5.21k/5.21k [00:00<00:00,
                                                          3.24MiB/s]
model.ckpt.meta: 100%|███████████████████████| 471k/471k [00:00<00:00,
                                                        2.46MiB/s]
vocab.bpe: 100%|██████████████████████████████| 456k/456k [00:00<00:00,
                                                         1.70MiB/s]
检查是否下载完全
检查 settings 和 params 的内容:
print("Settings:", settings)
print("Parameter dictionary keys:", params.keys())
执行结果:
print("Settings:", settings)
print("Parameter dictionary keys:", params.keys())
settings 和 params 都是Python字典:
settings字典存储了大语言模型架构的设置,类似于定义的GPT_CONFIG_124M。params字典包含实际的 权重张量
提示:只打印了字典的键
查看权重
可以通过
print(params)打印整个字典来检查这些 权重张量通过相应的 字典键(如嵌入层权重)来打印 单个张量:
print(params["wte"])
print("Token embedding weight tensor dimensions:", params["wte"].shape)
词元嵌入层的权重如下所示:
[[-0.11010301 ... -0.1363697   0.01506208   0.04531523]
 [ 0.04034033 ...  0.08605453  0.00253983   0.04318958]
 [-0.12746179  ...  0.08991534 -0.12972379 -0.08785918]
 ...
 [-0.04453601 ...   0.10435229  0.09783269 -0.06952604]
 [ 0.1860082  ...  -0.09625227  0.07847701 -0.02245961]
 [ 0.05135201 ...   0.00704835  0.15519823  0.12067825]]
Token embedding weight tensor dimensions: (50257, 768)
GPT2 其他的模型
上面代码是通过下面设置:
download_and_load_gpt2(model_size="124M", ...)
下载并加载了 最小的GPT-2模型的权重,即:1.2 亿
OpenAI还提供了 更大的模型(参数量分别为 3.55亿、 7.74亿 和 15.58亿)的权重。
如下图所示,这些不同大小的GPT模型的 整体架构是相同的,区别是 嵌入层大小 以及诸如 注意力头、 Transformer块 等个别组件的 重复次数
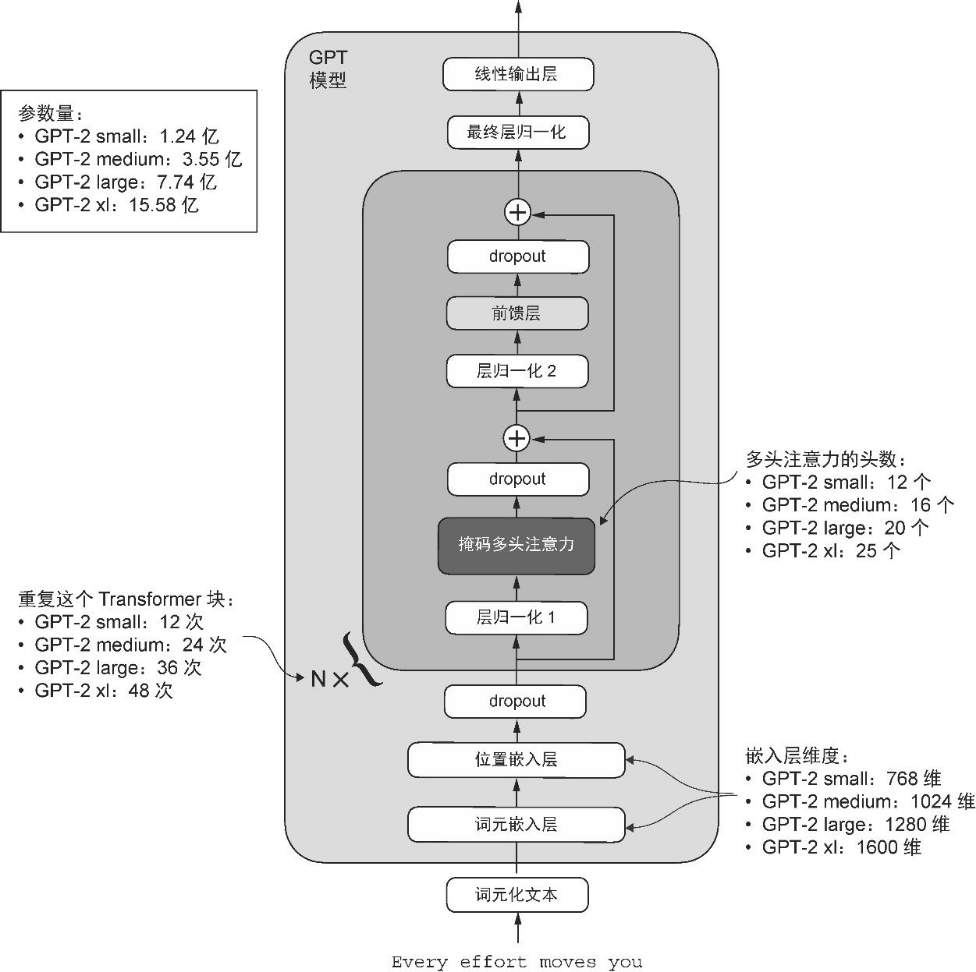
GPTModel模型加载GPT2的权重
接下来,将 GPT2的权重 加载到 GPTModel 实例中。
准备
从 大模型原理:全部代码 复制以下类或函数:
- MultiHeadAttention
- GELU
- FeedForward
- LayerNorm
- TransformerBlock
- GPTModel
- GPT_CONFIG_124M
第一步:修改配置
首先,创建一个字典,列出上图中不同GPT模型尺寸之间的 差异:
# 创建一个字典,列出图5-17中不同GPT模型尺寸之间的差异
model_configs = {
    "gpt2-small (124M)": {"emb_dim": 768, "n_layers": 12, "n_heads": 12},
    "gpt2-medium (355M)": {"emb_dim": 1024, "n_layers": 24, "n_heads": 16},
    "gpt2-large (774M)": {"emb_dim": 1280, "n_layers": 36, "n_heads": 20},
    "gpt2-xl (1558M)": {"emb_dim": 1600, "n_layers": 48, "n_heads": 25},
}
加载最小的模型 gpt2-small (124M),可以使用 model_configs 对应的设置来更新之前定义的GPT_CONFIG_124M:
model_name = "gpt2-small (124M)"
NEW_CONFIG = GPT_CONFIG_124M.copy()
NEW_CONFIG.update(model_configs[model_name])
之前使用了 256 个词元长度,但OpenAI的原始GPT-2模型是使用 1024 个词元长度进行训练的,因此需要相应地更新 NEW_CONFIG
# 之前使用了256个词元长度,但OpenAI的原始GPT-2模型是使用1024个词元长度进行训练的,因此需要相应地更新NEW_CONFIG
NEW_CONFIG.update({"context_length": 1024})
OpenAI在 多头注意力模块 的 线性层 中使用了 偏置向量 来实现查询矩阵(Query)、键矩阵(Key)和值矩阵(Value)的计算。
提示:偏置向量在当前的大语言模型中 不常用,因为它们 并不提升建模性能,因此不是必要的。
然而,由于正在使用 GPT2预训练权重,因此需要匹配相应的设置以保持一致性,并启用这些偏置向量:
# 启用偏置向量,兼容gpt2预训练权重
NEW_CONFIG.update({"qkv_bias": True})
print("NEW_CONFIG:", NEW_CONFIG)
第二步:初始化模型
使用更新后的 NEW_CONFIG 字典来初始化 GPTModel 实例:
# 使用更新后的NEW_CONFIG字典来初始化GPTModel实例
gpt = GPTModel(NEW_CONFIG)
gpt.eval()
第三步:定义 assign() 工具函数
检查 GPTModel 中的权重 和 GPT2 的权重,是否具有相同的维度或形状,如果相同,将 GPT2 的权重 加载到 torch.nn.Parameter,并返回;如果不相同,就报错
def assign(gpt_weight, params_weight):
    """
    检查gpt_weight, params_weight是否具有相同的维度或形状,
    如果相同,将 params_weight 权重加载到 torch.nn.Parameter,并返回
    如果不相同,就报错
    :param gpt_weight:GPTModel的权重
    :param params_weight:GPT2的权重
    :return:
    """
    if gpt_weight.shape != params_weight.shape:
        raise ValueError(f"Shape mismatch. Left: {gpt_weight.shape}, "
                          "Right: {right.shape}"
        )
    return torch.nn.Parameter(torch.tensor(params_weight))
第四步:加载权重
定义一个 load_weights_into_gpt() 函数,将 params 字典中的权重加载到 GPTModel 实例中
如:OpenAI将第一个 Transformer块 的输出投影层的权重张量存储为 params["blocks"][0]["attn"]["c_proj"]["w"]。在 GPTModel 实现中,该权重张量对应于 gpt.trf_blocks[b].att.out_proj.weight ,其中gpt是GPTModel实例
# 将params字典中的权重加载到GPTModel实例gpt中
import numpy as np


def load_weights_into_gpt(gpt, params):
    """
    将 `params` 字典中的权重加载到 `GPTModel` 实例
    :param gpt: GPTModel对象
    :param params: GPT2的params
    :return:
    """
    # 将模型的位置信息和词元嵌入权重设置为params中指定的值
    gpt.pos_emb.weight = assign(gpt.pos_emb.weight, params['wpe'])
    gpt.tok_emb.weight = assign(gpt.tok_emb.weight, params['wte'])
    # 遍历模型中的每一个 TransformerBlock 块
    for b in range(len(params["blocks"])):
        # np.split()函数用于将注意力和偏置权重平均分为3个部分,分别用于查询组件、键组件和值组件
        q_w, k_w, v_w = np.split(
            (params["blocks"][b]["attn"]["c_attn"])["w"], 3, axis=-1)
        gpt.trf_blocks[b].att.W_query.weight = assign(
            gpt.trf_blocks[b].att.W_query.weight, q_w.T)
        gpt.trf_blocks[b].att.W_key.weight = assign(
            gpt.trf_blocks[b].att.W_key.weight, k_w.T)
        gpt.trf_blocks[b].att.W_value.weight = assign(
            gpt.trf_blocks[b].att.W_value.weight, v_w.T)

        q_b, k_b, v_b = np.split(
            (params["blocks"][b]["attn"]["c_attn"])["b"], 3, axis=-1)
        gpt.trf_blocks[b].att.W_query.bias = assign(
            gpt.trf_blocks[b].att.W_query.bias, q_b)
        gpt.trf_blocks[b].att.W_key.bias = assign(
            gpt.trf_blocks[b].att.W_key.bias, k_b)
        gpt.trf_blocks[b].att.W_value.bias = assign(
            gpt.trf_blocks[b].att.W_value.bias, v_b)

        gpt.trf_blocks[b].att.out_proj.weight = assign(
            gpt.trf_blocks[b].att.out_proj.weight,
            params["blocks"][b]["attn"]["c_proj"]["w"].T)
        gpt.trf_blocks[b].att.out_proj.bias = assign(
            gpt.trf_blocks[b].att.out_proj.bias,
            params["blocks"][b]["attn"]["c_proj"]["b"])

        gpt.trf_blocks[b].ff.layers[0].weight = assign(
            gpt.trf_blocks[b].ff.layers[0].weight,
            params["blocks"][b]["mlp"]["c_fc"]["w"].T)
        gpt.trf_blocks[b].ff.layers[0].bias = assign(
            gpt.trf_blocks[b].ff.layers[0].bias,
            params["blocks"][b]["mlp"]["c_fc"]["b"])
        gpt.trf_blocks[b].ff.layers[2].weight = assign(
            gpt.trf_blocks[b].ff.layers[2].weight,
            params["blocks"][b]["mlp"]["c_proj"]["w"].T)
        gpt.trf_blocks[b].ff.layers[2].bias = assign(
            gpt.trf_blocks[b].ff.layers[2].bias,
            params["blocks"][b]["mlp"]["c_proj"]["b"])

        gpt.trf_blocks[b].norm1.scale = assign(
            gpt.trf_blocks[b].norm1.scale,
            params["blocks"][b]["ln_1"]["g"])
        gpt.trf_blocks[b].norm1.shift = assign(
            gpt.trf_blocks[b].norm1.shift,
            params["blocks"][b]["ln_1"]["b"])
        gpt.trf_blocks[b].norm2.scale = assign(
            gpt.trf_blocks[b].norm2.scale,
            params["blocks"][b]["ln_2"]["g"])
        gpt.trf_blocks[b].norm2.shift = assign(
            gpt.trf_blocks[b].norm2.shift,
            params["blocks"][b]["ln_2"]["b"])

    gpt.final_norm.scale = assign(gpt.final_norm.scale, params["g"])
    gpt.final_norm.shift = assign(gpt.final_norm.shift, params["b"])
    gpt.out_head.weight = assign(gpt.out_head.weight, params["wte"])
调用 load_weights_into_gpt(),将OpenAI模型权重加载到 GPTModel 实例gpt中:
load_weights_into_gpt(gpt, params)
device = "cpu"
gpt.to(device)
第五步:测试生成文本
如果模型成功加载,那么现在可以使用之前的 generate 函数来生成新文本:
准备:
def generate(model, idx, max_new_tokens, context_size, temperature=0.0, top_k=None, eos_id=None):
    """
    生成文本
    :param model:
    :param idx:
    :param max_new_tokens:
    :param context_size:
    :param temperature:
    :param top_k:
    :param eos_id:
    :return:
    """
    # For-loop is the same as before: Get logits, and only focus on last time step
    for _ in range(max_new_tokens):
        idx_cond = idx[:, -context_size:]
        with torch.no_grad():
            logits = model(idx_cond)
        logits = logits[:, -1, :]

        # New: Filter logits with top_k sampling
        if top_k is not None:
            # Keep only top_k values
            top_logits, _ = torch.topk(logits, top_k)
            min_val = top_logits[:, -1]
            logits = torch.where(logits < min_val, torch.tensor(float('-inf')).to(logits.device), logits)

        # New: Apply temperature scaling
        if temperature > 0.0:
            logits = logits / temperature

            # Apply softmax to get probabilities
            probs = torch.softmax(logits, dim=-1)  # (batch_size, context_len)

            # Sample from the distribution
            idx_next = torch.multinomial(probs, num_samples=1)  # (batch_size, 1)

        # Otherwise same as before: get idx of the vocab entry with the highest logits value
        else:
            idx_next = torch.argmax(logits, dim=-1, keepdim=True)  # (batch_size, 1)

        if idx_next == eos_id:  # Stop generating early if end-of-sequence token is encountered and eos_id is specified
            break

        # Same as before: append sampled index to the running sequence
        idx = torch.cat((idx, idx_next), dim=1)  # (batch_size, num_tokens+1)

    return idx


def text_to_token_ids(text, tokenizer):
    """
    将文本编码为词元
    :param text:
    :param tokenizer:
    :return:
    """
    encoded = tokenizer.encode(text, allowed_special={'<|endoftext|>'})
    encoded_tensor = torch.tensor(encoded).unsqueeze(0) # add batch dimension
    return encoded_tensor

def token_ids_to_text(token_ids, tokenizer):
    """
    将词元解码为文本
    :param token_ids:
    :param tokenizer:
    :return:
    """
    flat = token_ids.squeeze(0)  # remove batch dimension
    return tokenizer.decode(flat.tolist())


import tiktoken

tokenizer = tiktoken.get_encoding("gpt2")
生成文本:
# 使用之前的generate函数来生成新文本
input_text = "Every effort moves you"
torch.manual_seed(123)
token_ids = generate(
    model=gpt,
    idx=text_to_token_ids(input_text, tokenizer).to(device),
    max_new_tokens=25,
    context_size=NEW_CONFIG["context_length"],
    top_k=50,
    temperature=1.5
)
output_text = token_ids_to_text(token_ids, tokenizer)
print("生成文本:\n", output_text)
执行结果:
Every effort moves you toward finding an ideal new way to practice something!

What makes us want to be on top of that?
模型能够生成连贯的文本,说明已经正确加载了模型权重