groupByKey
生成的 RDD 是 key-value,value是集合,其元素是源RDD中的value组成的
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)
val rdd = sc.makeRDD(List(("李雷",2),("韩梅梅",3),("李雷",3)))

//value是集合,其元素是源RDD中的value组成的
val resRDD: RDD[(String, Iterable[Int])]=rdd.groupByKey()

resRDD.collect()
resRDD.foreach(println)
sc.stop()
执行结果:
(李雷,CompactBuffer(2, 3))
(韩梅梅,CompactBuffer(3))
groupBy
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)
val rdd = sc.makeRDD(List(("李雷",2),("韩梅梅",3),("李雷",3)))

//value是集合,其元素是源RDD中的 (key,value)组成的
val resRDD:RDD[(String, scala.Iterable[(String, Int)])]=rdd.groupBy( _._1)

resRDD.collect()
resRDD.foreach(println)
sc.stop()
groupBy 与 reduceByKey 区别
shuffle 区别:
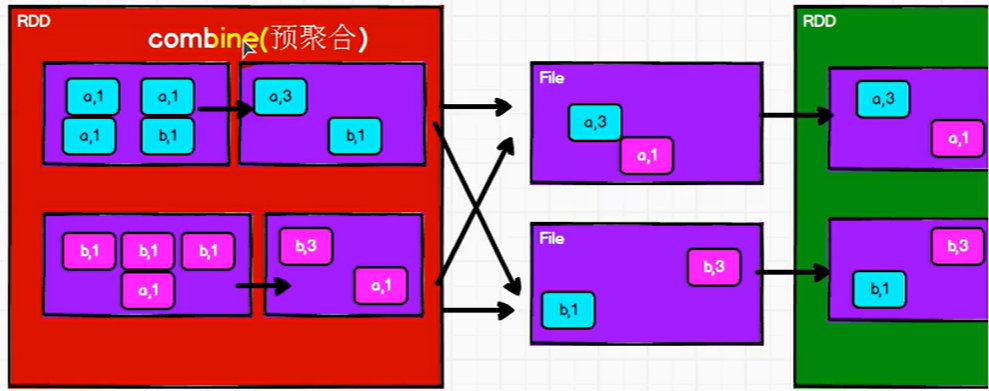
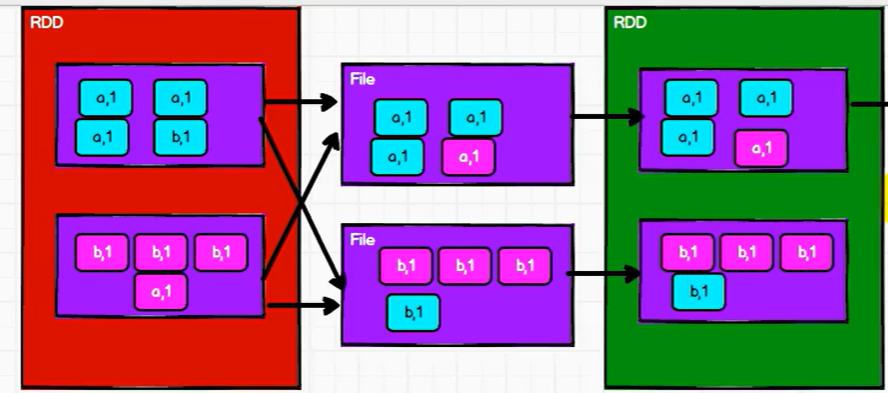
reduceByKey 和 groupByKey 都存在 shuffle 的操作
reduceByKey:可以在 shuffle 前对分区内相同 key 的数据进行预聚合(combine)功能,这样会减少存储的数据量,reduceByKey 性能比较高。
groupByKey:只是进行分组,不存在数据量减少的问题,
功能区别:
reduceByKey 包含 分组 和 聚合 的功能,在分组聚合时推荐使用
GroupByKey 只能分组,不能聚合,在仅需要分组不需要聚合时,推荐使用