废弃
见 flink1.12.x checkpoint:从检查点恢复状态
说明
在执行流应用程序期间,Flink 会定期保存状态的一致检性查点。如果发生故障, 将会使用最近的检查点来一致恢复应用程序的状态,并重新启动处理流程。就要从之前存盘的检查点恢复,从新读取数据处理,流程如下:
重启
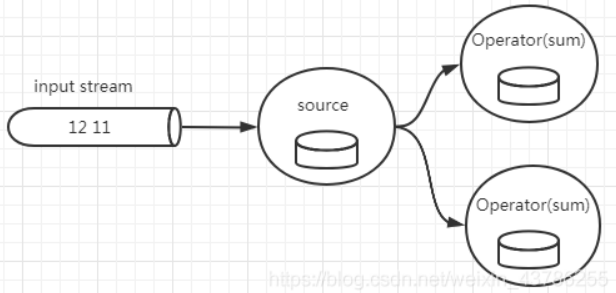
首先重启应用,外部系统不知道,所有 状态都是空的
恢复
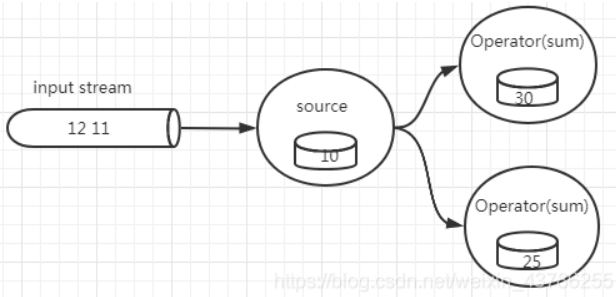
然后从checkpoint恢复状态重置,这个是8处理完的时间点,source那里保存了偏移量,需要给数据源那里重新提交偏移量。
继续计算
开始消费并处理检查点到发生故障之间的所有数据,这样就好像错误没有发生,这就是Flink的checkpoint检查点机制保证了,内存状态的精确一次。因为所有算子都会保存检查点并恢复其所有状态,这样一来所有的输入流就都会被重置到检查点完成时的位置