本文代码在 hadoop3.x MapReduce-Partition分区的实现 基础上修改
注意1
如果 1 < job.setNumReduceTasks(n) 中的 n < getPartition() 返回值数量 ,则有一部分分区数据无处存放,会报错;
例子
数据如下,有3个日期:
1,100,2020-01-01 09:30:50,2020-01-01 09:40:50
2,200,2020-01-11 10:40:50,2020-01-11 11:05:50
3,150,2020-03-01 11:20:50,2020-03-01 11:32:50
1,50,2020-02-02 12:30:50,2020-02-02 12:35:50
1,300,2020-01-03 14:30:50,2020-01-03 15:20:10
2,500,2020-02-02 15:30:30,2020-02-02 17:20:30
3,400,2020-03-02 17:30:20,2020-03-02 18:20:20
设置 reduce task 数量是2:
job.setNumReduceTasks(2);
执行报错:
java.lang.Exception: java.io.IOException: Illegal partition for 3 (2)
    at org.apache.hadoop.mapred.LocalJobRunner$Job.runTasks(LocalJobRunner.java:492)
    at org.apache.hadoop.mapred.LocalJobRunner$Job.run(LocalJobRunner.java:552)
Caused by: java.io.IOException: Illegal partition for 3 (2)
    at org.apache.hadoop.mapred.MapTask$MapOutputBuffer.collect(MapTask.java:1096)
    at org.apache.hadoop.mapred.MapTask$NewOutputCollector.write(MapTask.java:727)
    at org.apache.hadoop.mapreduce.task.TaskInputOutputContextImpl.write(TaskInputOutputContextImpl.java:89)
    at org.apache.hadoop.mapreduce.lib.map.WrappedMapper$Context.write(WrappedMapper.java:112)
    at partition.MyMapper.map(MyMapper.java:50)
    at partition.MyMapper.map(MyMapper.java:1)
    at org.apache.hadoop.mapreduce.Mapper.run(Mapper.java:146)
    at org.apache.hadoop.mapred.MapTask.runNewMapper(MapTask.java:799)
    at org.apache.hadoop.mapred.MapTask.run(MapTask.java:347)
    at org.apache.hadoop.mapred.LocalJobRunner$Job$MapTaskRunnable.run(LocalJobRunner.java:271)
    at java.util.concurrent.Executors$RunnableAdapter.call(Executors.java:511)
    at java.util.concurrent.FutureTask.run(FutureTask.java:266)
    at java.util.concurrent.ThreadPoolExecutor.runWorker(ThreadPoolExecutor.java:1149)
    at java.util.concurrent.ThreadPoolExecutor$Worker.run(ThreadPoolExecutor.java:624)
    at java.lang.Thread.run(Thread.java:748)
注意2
如果 job.setNumReduceTasks(n) 中的 n > getPartition() 返回值数量 ,会产生几个空的输出文件
提示:一般不要这么设置,会浪费 CPU、内存资源,除非有此业务需求
注意3
如果 job.setNumReduceTasks(n) 中的 n = 1 ,最终只产生一个结果文件
而且,没有执行我们自定义的 Partitioner 类
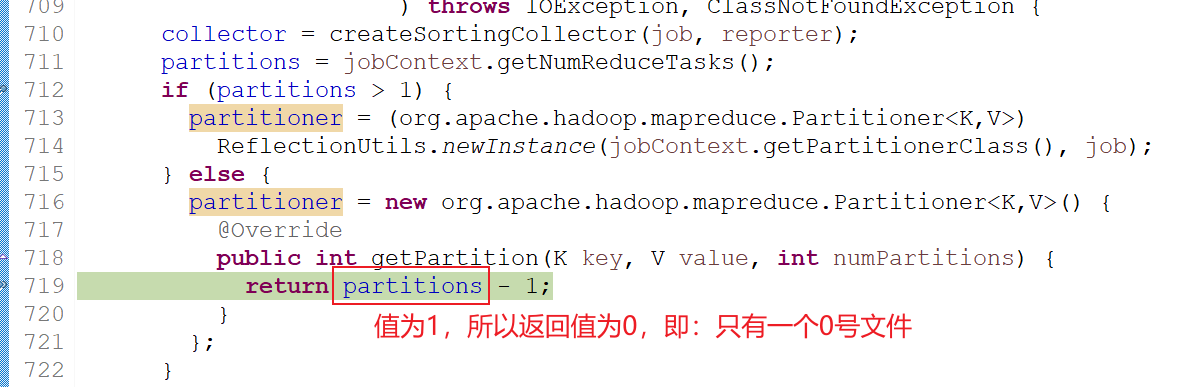
注意4
分区号从零开始,每个分区加1,不能跳着加