二叉树
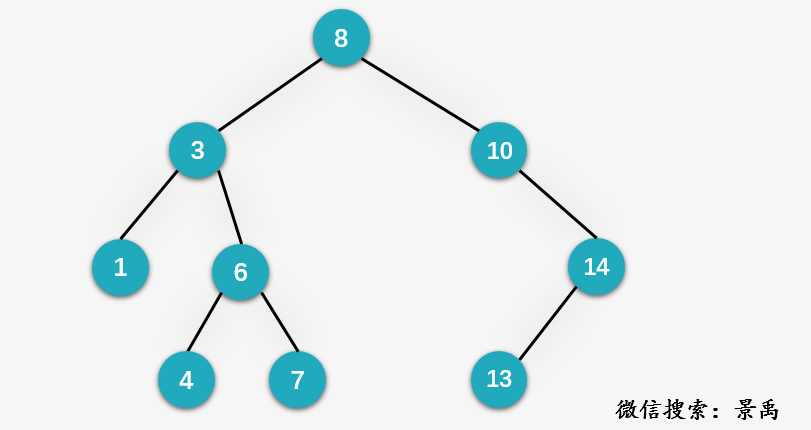
每个节点最多 2 个子节点(左、右),如下图
作用
- 基础结构,用于构建更高级树(BST、AVL、红黑树、堆、哈夫曼树)
- 表示 二分决策结构(决策树、表达式树)
- 遍历(前 / 中 / 后 / 层序)是很多算法基础
优点
- 结构简单,容易实现
- 遍历、递归处理非常自然
- 很多高级树都是基于它扩展
缺点
- 有海量节点,会造成二叉树的层数比较多(高度非常大),降低操作速度
- 二叉树因为层数比较多(高度非常大),只适合在内存中构建、查找,优势才能体现,在内存中使用,导致节点不能太多
- 如果存在硬盘上,每层查找都需要向硬盘进行I/O操作,性能会降低
多叉树
每个节点可以有多个子节点,如下是2-3树,有2个节点 或 3个节点:

作用
- 表示更宽的层级结构(文件系统、XML、DOM、目录)
- 减少树高度,提高缓存命中率
- 数据库索引(B 树 / B+ 树)
优点
- 层数少(树更矮),可以减少io操作
- 适合大数据、存放在硬盘上
- 层级表达更自然
缺点
- 子节点管理复杂
- 遍历 / 搜索比二叉树麻烦
为什么层数多少,与 I/O 多少有关
树结构查找数据的过程是:从根节点出发,一层一层往下找,直到叶子节点。
每访问一层节点,通常就对应一次磁盘 I/O。
因为节点是存在磁盘上的,你要判断走左还是走右,必须先把这个节点从磁盘读到内存里。
公式
查找某条数据的 I/O 次数 ≈ 树的高度(层数)
例子
假设要存 1 亿 条数据。
用二叉树
每个节点存 1 个数据,2 个分叉。
树高大约是:\log_2100000000 \approx 26.5 层
最坏情况:找一条数据,要读
26次磁盘。
用多叉树(B + 树)
数据库索引(如 MySQL)用的是 B + 树,每个节点可以存 成百上千个数据(比如 1000 个),分叉极多。
每个节点存 1000 个数据,1000 个分叉。
树高大约是:\log_{1000}100000000 \approx 2.67 层
最坏情况:找一条数据,只需要读
3次磁盘。
差距有多大?
- 二叉树:26 次 I/O
- B + 树:3 次 I/O
速度差了将近 10 倍! 这就是为什么数据库不用二叉树做索引,非要用复杂的多叉 B + 树。
总结
- 二叉树是 “高瘦” 的
- 多叉树是 “矮胖” 的