概述
python为了提高运行效率,可以 创建进程,让CPU同时执行多个任务
应用场景
计算密集型的任务主要消耗CPU,所以计算密集型的任务一般使用多进程。
如:科学计算、视频解码
操作系统与创建进程
为了提高运行效率,主流操作系统提供创建进程的函数,供程序员调用。
注意:不同的操作系统,提供创建进程的 函数 可能不同,UNIX、linux、Mac OS相同,但MS Windows系统与前几种不同。
由于python是跨平台的,通过类
multiprocessing.Process 可以在主流操作系统中实现创建进程的功能
感性认识
普通方式:
#coding=utf-8
import os

def fun():
    #无限循环
    while True:
        pass

if __name__ == "__main__":
    #打印当前进程的pid
    print('pid=',os.getpid(),',父进程pid=',os.getppid(),',cpu核心数=',os.cpu_count())
    fun()
在控制台中执行(为了便于查看进程,不要在IDE中执行):
父进程截图如下:
在命令提示符中启动python,所以父进程是命令窗口的进程ID
python进程截图如下:
注意:
由于是无限循环,CPU利用率应该是100%,但这里是25%,原因是双核4线程,逻辑上相当于4个CPU,只用一个CPU运行该python进程,而且是满负荷运转,也只占1/4,所以是25%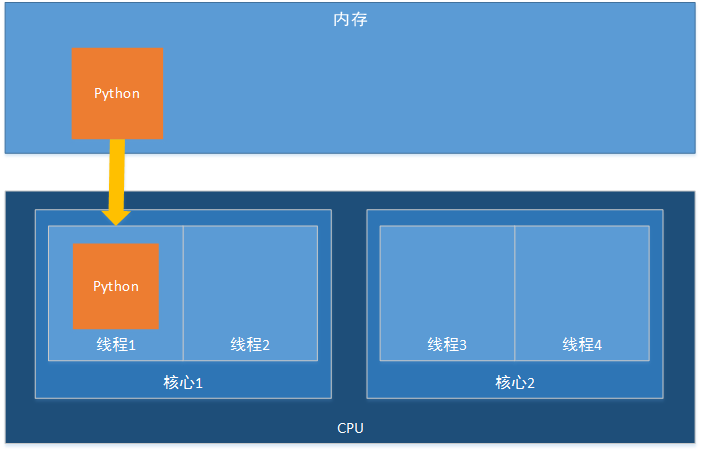
注意: CPU中的超线程,简单说就是模拟多个CPU核心,与操作系统中的线程不是一个概念
结论:
单进程无法充分利用多核CPU
多进程方式
通过下面代码,感性认识python创建进程的方法,父进程、子进程的执行过程
#coding=utf-8

import time
from multiprocessing import Process
import os

#假设该函数执行耗时的任务
def task():
    #无限循环
    while True:
        pass

#必须有下面这行代码,否则在windows下报错
if __name__ == "__main__":
    #打印当前进程的pid
    print('pid=',os.getpid(),',父进程pid=',os.getppid(),',cpu核心数=',os.cpu_count())
    p=Process(target=fun)
    p.start()
    p2=Process(target=fun)
    p2.start()
    p3=Process(target=fun)
    p3.start()
    fun()
在控制台中执行(为了便于查看进程,不要在IDE中执行):
python进程截图如下:
注意:
PID是8572的进程创建了3个进程,这3个进程都执行fun()函数,也就是4个进程都在执行fun()函数,4个CPU都在同时满负荷运转,分别是25%,多核CPU真正达到100%利用率
结论:
多进程能够充分利用多核CPU
Process使用说明
创建对象
语法:
Process([group [, target [, name [, args [, kwargs]]]]])
参数说明:
- group:一般不使用
- target:表示调用对象
- name:为别名
- args:表示调用对象的位置参数元组
- kwargs:表示调用对象的关键字参数字典
常用属性
name:当前进程别名,在实例化时通过参数name指定,默认为Process=N,N为从1开始递增的整数
pid:当前进程实例的pid
常用方法
start():启动进程实例
is_alive():判断进程实例是否还在执行,返回布尔值
join([timeout]):参见python-Process之join()的使用
run():参见python-Process子类创建进程
terminate():不管任务是否完成,立即终止
Process创建进程
#coding=utf-8

import time
from multiprocessing import Process
import os

#打印进程id,父进程id
print('文件开始---,pid=%d,ppid=%d'%(os.getpid(),os.getppid()))

def fun():
    print('子进程开始,pid=%d,ppid=%d'%(os.getpid(),os.getppid()))
    time.sleep(15)
    print('子进程结束,pid=%d,ppid=%d'%(os.getpid(),os.getppid()))

#打印__name__,查看打印结果
print('__name__=',__name__)
if __name__ == "__main__":
    #打印进程id
    print('主进程开始,pid=%d,ppid=%d'%(os.getpid(),os.getppid()))
    #创建子进程,让子进程运行fun函数,当fun()函数执行结束之后,子进程也结束
    p=Process(target=fun)
    #启动进程
    p.start()
    # time.sleep(10)
    #子进程pid和name
    print('子进程pid=%d,name=%s'%(p.pid,p.name))
    print('主进程结束,pid=%d,ppid=%d'%(os.getpid(),os.getppid()))
执行结果:
文件开始---,pid=8392,ppid=392
__name__= __main__
主进程开始,pid=8392,ppid=392
子进程pid=8404,name=Process-1
主进程结束,pid=8392,ppid=392
文件开始---,pid=8404,ppid=8392
__name__= __mp_main__
子进程开始,pid=8404,ppid=8392
子进程结束,pid=8404,ppid=8392
分析结果:
- python主进程执行该py文件,打印
文件开始---,pid=8392,ppid=392 - python主进程执行21-23行代码时,创建子进程并执行,然后主进程继续执行
- python子进程执行该py文件,再次打印
文件开始---,pid=8392,ppid=392 - python子进程执行fun()函数
进程截图如下:
cmd进程
cmd进程启动python解释器(pid是8392),python解释器执行py文件,python解释器(pid是8392)创建子进程(pid是8404)

创建并启动子进程后,父进程仍然继续执行
观察运行结果,父进程创建并启动子进程后,父进程仍然继续执行
子进程运行结束,父进程才会结束
观察运行结果和任务管理器,虽然控制台打印出主进程结束,pid=8392,ppid=392,但在任务管理器中可以看到父进程仍然运行,没有结束
特点:
父进程(主进程)会等所有子进程执行完毕之后才结束
子进程的__name__
子进程的__name__值为 __mp_main__
多个进程的运行顺序
创建多个子进程,观察子进程的运行顺序
改造上面的代码,如下:
#coding=utf-8
import time,os,multiprocessing
from multiprocessing import Process

#打印进程id,父进程id
print('文件开始---,pid=%d,ppid=%d'%(os.getpid(),os.getppid()))

def fun():
    for index in range(5):
        print('子进程运行,name=%s,\tpid=%d,\tppid=%d'%(multiprocessing.current_process().name,os.getpid(),os.getppid()))
        time.sleep(1)

if __name__ == "__main__":
    #打印进程id
    print('主进程开始,pid=%d,ppid=%d'%(os.getpid(),os.getppid()))
    for index in range(4):
        #创建进程,设置进程名字,并且传值
        p=Process(target=fun,name='myprocess-%s'%index)
        #启动进程
        p.start()
        #子进程pid和name
        print('子进程pid=%d,name=%s'%(p.pid,p.name))
    print('主进程结束,pid=%d,ppid=%d'%(os.getpid(),os.getppid()))
从运行结果可知,运行顺序混乱,每个子进程 执行顺序 受 操作系统 的控制
总结
在多核CPU中,但进程不能100%发挥CPU的性能(其他硬件也是如此),通过多进程并发运行,更好的利用硬件,提高运行效率
Process类创建进程的特点:
- 父进程(主进程)会等所有子进程执行完毕之后才结束
- 创建并启动子进程后,父进程仍然继续执行
感谢
https://www.cnblogs.com/kaituorensheng/p/4445418.html