概述
对 文本数据 进行特征抽取,即:统计各个词出现的次数
应用场景
比如文章分类、是否垃圾邮件、自然语言处理中的情感分析等
导入包
sklearn.feature_extraction.text
类
CountVectorizer()
参数
无
返回值
返回对象
将 文本 转成 数字特征
fit_transform(X)
参数
- X:字符串 或者 包含字符串的迭代器
如:['Well I wonder could it be','When I was dreaming about you baby']
返回值
- 返回sparse(节约内存,方便处理)
调用toarray()将sparse结构转成array
返回类别名称
get_feature_names()
返回值
类别名称,list类型
例子
# coding=utf-8
from sklearn.feature_extraction.text import CountVectorizer

# 实例化
vector=CountVectorizer()

# 调用fit_transform输入并转换数据
data=vector.fit_transform(['Every night in my dreams','I see you','You have come to show you go on'])
# 打印结果
print(vector.get_feature_names())
# 返回sparse类型
print(data)
# 转成array类型
print(data.toarray())
打印结果:
['come', 'dreams', 'every', 'go', 'have', 'in', 'my', 'night', 'on', 'see', 'show', 'to', 'you']
  (0, 1)        1
  (0, 6)        1
  (0, 5)        1
  (0, 7)        1
  (0, 2)        1
  (1, 12)       1
  (1, 9)        1
  (2, 8)        1
  (2, 3)        1
  (2, 10)       1
  (2, 11)       1
  (2, 0)        1
  (2, 4)        1
  (2, 12)       2
[[0 1 1 0 0 1 1 1 0 0 0 0 0]
 [0 0 0 0 0 0 0 0 0 1 0 0 1]
 [1 0 0 1 1 0 0 0 1 0 1 1 2]]
解释:
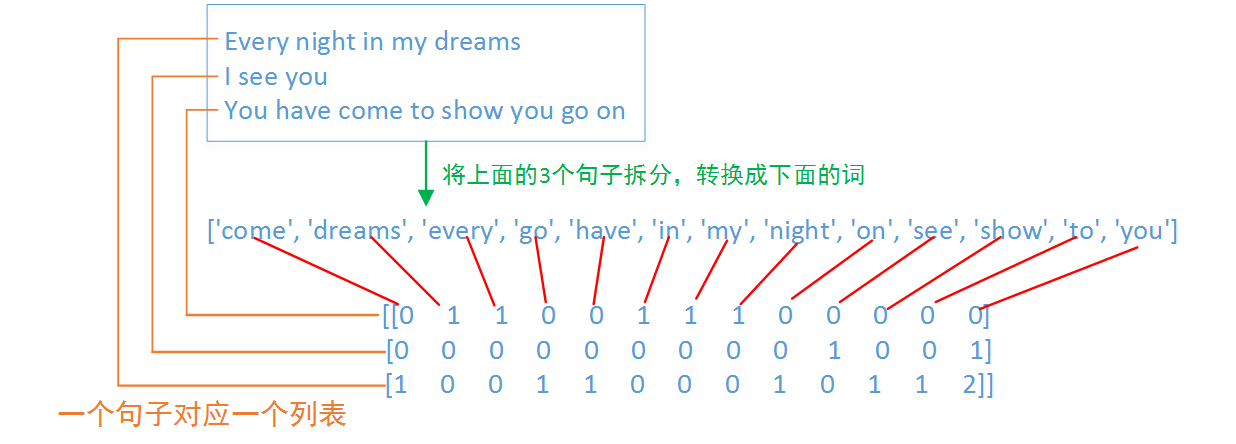
列表
['Every night in my dreams','I see you','You have come to show you go on']的每一个元素表示一篇文章统计各文章的词出现的次数
没出现的记为0,出现1次的记为1,出现2次的记为2单个字母不统计,一般单个字母没有意义
转换成之前的数据格式
inverse_transform(X)
参数
- X:调用fit_transform(X)返回的结果,array 或者 sparse矩阵
返回值
转换成之前的数据格式