概述
对 字典数据 进行数字化
导入包
sklearn.feature_extraction
- feature:特征
- extraction:抽取
类
DictVectorizer(sparse=True)
参数
- sparse:见下面的返回值
将 字典特征 转成 数字特征
fit_transform(X)
参数
- X:字典 或者 包含字典的迭代器
如:[{'name':'李雷','age':20},{'name':'韩梅梅','age':19}]
返回值
- 当实例化时指定sparse=True,返回sparse(节约内存,方便处理)
- 指定sparse=False,返回array二维数组
返回类别名称
get_feature_names()
返回值
类别名称,list类型
例子1
# coding=utf-8
from sklearn.feature_extraction import DictVectorizer

vector=DictVectorizer(sparse=False)
d=[{'name':'李雷','age':20,'sex':'男'},{'name':'韩梅梅','age':19,'sex':'女'},{'name':'lucy','age':20,'sex':'女'},{'name':'lili','age':20,'sex':'女'}]
data=vector.fit_transform(d)
print(vector.get_feature_names())
print(data)
打印结果:
['age', 'name=lili', 'name=lucy', 'name=李雷', 'name=韩梅梅', 'sex=女', 'sex=男']
[[20.  0.  0.  1.  0.  0.  1.]
 [19.  0.  0.  0.  1.  1.  0.]
 [20.  0.  1.  0.  0.  1.  0.]
 [20.  1.  0.  0.  0.  1.  0.]]
实例化DictVectorizer(sparse=False)时指定sparse=False,所以转换后的结果是array结构,如下图: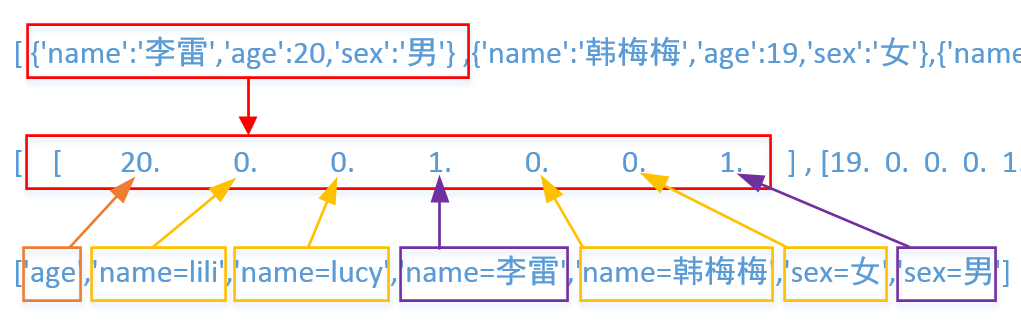
这种表示方法称之为: One-Hot Encoding 独热编码
例子2
from sklearn.feature_extraction import DictVectorizer

vector=DictVectorizer()
d=[
    {'name':'李雷','age':20,'sex':'男'},
    {'name':'韩梅梅','age':19,'sex':'女'},
    {'name':'lucy','age':20,'sex':'女'},
    {'name':'lili','age':20,'sex':'女'}
    ]
data=vector.fit_transform(d)
print(vector.get_feature_names())
print(data)
返回的data是 sparse结构,打印结果:
['age', 'name=lili', 'name=lucy', 'name=李雷', 'name=韩梅梅', 'sex=女', 'sex=男']
  (0, 0)        20.0
  (0, 3)        1.0
  (0, 6)        1.0
  (1, 0)        19.0
  (1, 4)        1.0
  (1, 5)        1.0
  (2, 0)        20.0
  (2, 2)        1.0
  (2, 5)        1.0
  (3, 0)        20.0
  (3, 1)        1.0
  (3, 5)        1.0
转换成之前的数据格式
inverse_transform(X)
参数
- X:调用fit_transform(X)返回的结果,array 或者 sparse矩阵
返回值
转换成之前的数据格式
例子
# coding=utf-8
from sklearn.feature_extraction import DictVectorizer

vector=DictVectorizer(sparse=False)
d=[
    {'name':'李雷','age':20,'sex':'男'},
    {'name':'韩梅梅','age':19,'sex':'女'},
    {'name':'lucy','age':20,'sex':'女'}
    ]
data=vector.fit_transform(d)
print(vector.get_feature_names())
print(data)
print(data[0][0])

data=vector.inverse_transform(data)
print(data)
打印结果如下:
[{'age': 20.0, 'name=李雷': 1.0, 'sex=男': 1.0}, {'age': 19.0, 'name=韩梅梅': 1.0, 'sex=女': 1.0}, {'age': 20.0, 'name=lucy': 1.0, 'sex=女': 1.0}]
方法4
transform(X)
转换之前数据格式