概述
该案例中,前14列是特征,脱敏数据,也就是说不需要搞清楚代表什么含义
最后1列是结果,通过分析,结果是1和-1,也就是二分类问题
读取数据
import numpy as np
import collections

data= np.loadtxt(r'C:\Users\mym\Desktop\数据集\credit-a.csv',delimiter=',')
print(data.shape)
print(data)
处理数据
# 处理数据

# 查看目标值是否只有两个
print(collections.Counter(data[:,-1]))

data[:,-1][data[:,-1]==-1]=0


print(collections.Counter(data[:,-1]))
print(data)
拆分数据
# 拆分数据
size=len(data)
print(size)
train_size=int(size*0.7)
print(train_size)


x=data[:train_size,:-1]
y=data[:train_size,-1]
print(x)
print(y)

print(x.shape)
print(y.shape)

x_test=data[train_size:,:-1]
y_test=data[train_size:,-1]

print(x_test.shape)
print(y_test.shape)
建模
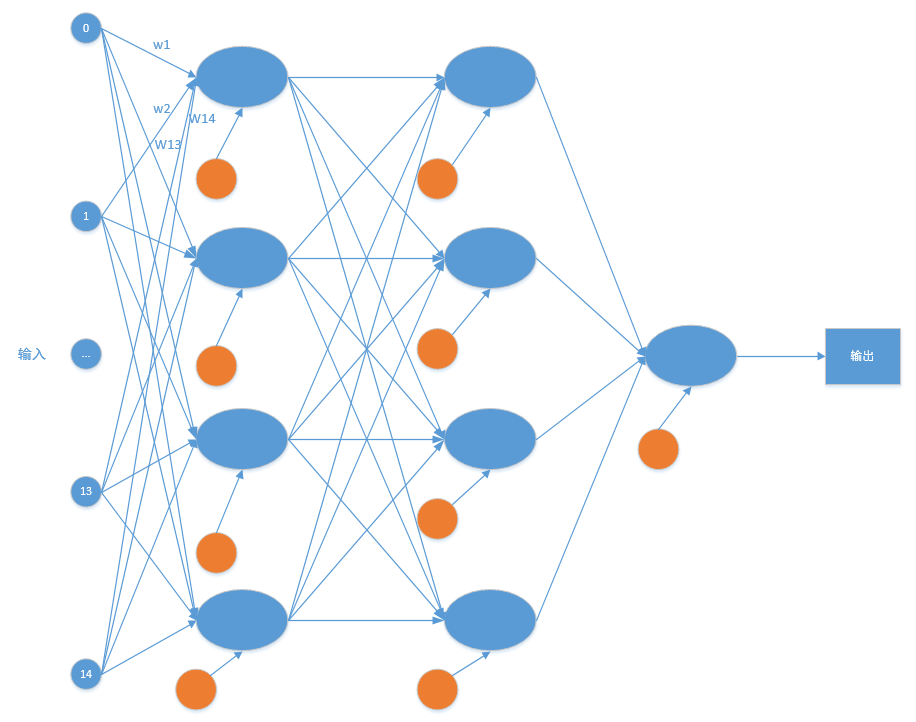
import tensorflow as tf
model=tf.keras.Sequential()
model.add(tf.keras.layers.Dense(4,input_shape=(15,),activation='relu'))
model.add(tf.keras.layers.Dense(4,activation='relu'))
model.add(tf.keras.layers.Dense(1,activation='sigmoid'))

# model.add(tf.keras.layers.Dense(1,input_shape=(15,),activation='sigmoid'))
model.summary()
运行
# 获取准确率
model.compile(optimizer='adam',loss='binary_crossentropy',metrics=['acc'])

history=model.fit(x,y,epochs=300)
打印权重
print(model.layers[0].get_weights())
print(model.layers[1].get_weights())
print(model.layers[2].get_weights())
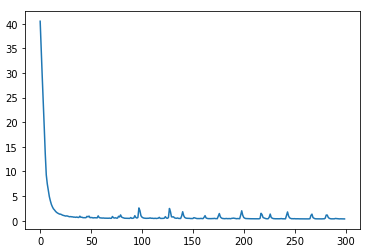
将循环次数和损失值绘制成图像
history.history.keys()

import matplotlib.pyplot as plt
plt.plot(history.epoch,history.history['loss'])
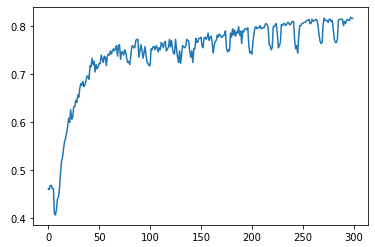
将循环次数和准确率绘制成图像
plt.plot(history.epoch,history.history['acc'])
评估
model.evaluate(x_test,y_test)
执行结果
[0.430810809135437, 0.8469388]
正确率是0.8469388
预测
对测试集进行预测
y_prd=model.predict(x_test).flatten()
print(y_prd.shape)
print(y_prd)
分析预测结果
对预测结果改造:
输出的是概率值,对概率值改造:大于等于0.5的改为1,小于等于0.5的改为0
y_prd[y_prd>=0.5]=1
y_prd[y_prd<=0.5]=0

y_prd.shape,y_prd
统计错误结果:
error_count=0
for item in range(len(y_prd)):
    if y_test[item]!=y_prd[item]:
        error_count+=1
        print(item,'---',y_test[item],'---',y_prd[item])

print('错误数量:',error_count)
算准确率
1-error_count/len(y_prd)