概述
本文介绍分组中的单列聚合函数,也就是说 分组后,只能对 一列 进行 聚合 操作
如下面例子,根据性别分组,然后取出身高最高的记录
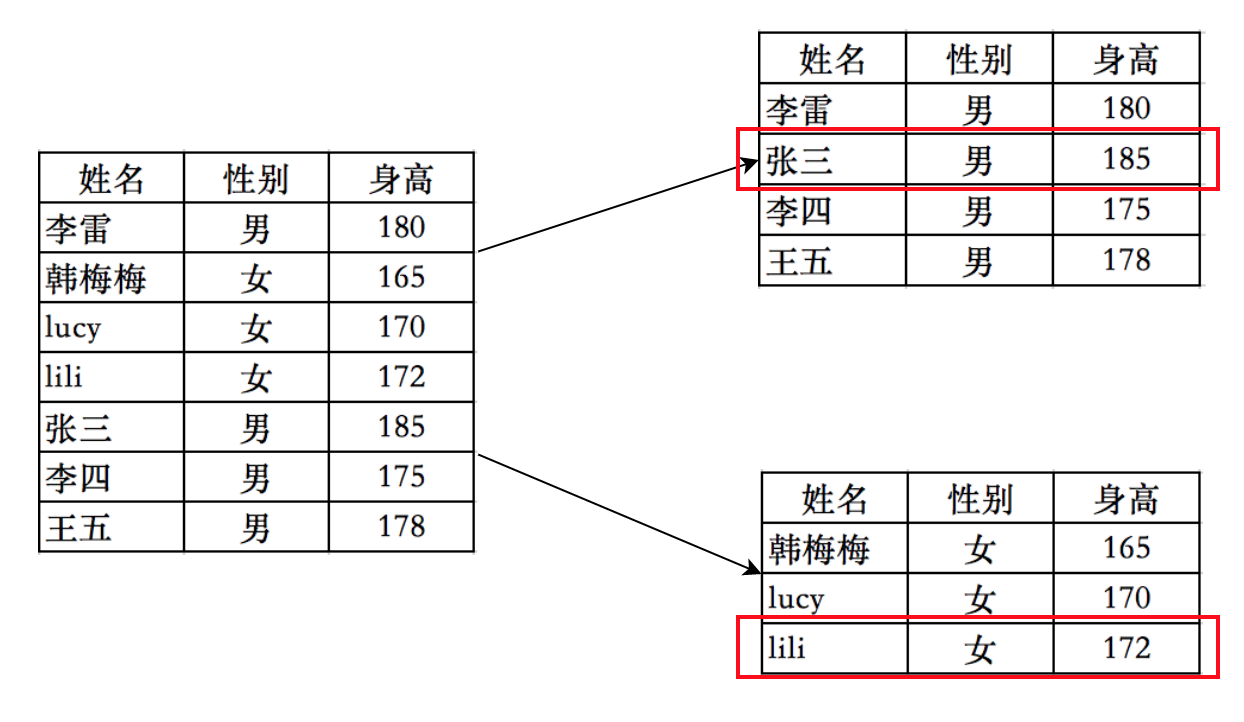
分组函数
用法:
df.groupby(by='列标签').聚合函数()
聚合函数
| 操作 | 解释 |
|---|---|
| count | 计算分组中非NA值的数量 |
| sum | 计算非NA值的和 |
| mean | 计算非NA值的平均值 |
| min | 获得非NA值的最小值 |
| max | 获得非NA值的最大值 |
| median | 计算非NA值的算术中位数 |
| std | 计算非NA值标准差 |
| var | 计算非NA值方差 |
| first | 获得第一个非NA值 |
| last | 获得最后一个非NA值 |
sum() 求某列的和
求某列(非NA值)的和
需要用到数据集:SELL.csv,文件格式如下:

根据Sell_No分组,求Volume的和
import pandas as pd

df = pd.read_csv("SELL.csv", index_col=[0])
dfgb=df.groupby(by='Sell_No')
dfgb["Volume"].sum()
mean() 求某列平均数
求某列(非NA值)的平均数
需要用到数据集:SELL.csv,文件格式如下:
根据 Sell_No 分组,求 Prices 列的平均数
import pandas as pd

df = pd.read_csv("SELL.csv", index_col=[0])
dfgb=df.groupby(by='Sell_No')
dfgb["Prices"].mean()
count()
统计分组中非NaN值的数量
分组统计总数
import pandas as pd
df=pd.read_csv('train.csv')
dfgb=df.groupby(by='Sex')
print(dfgb.count())
结果如下:
        PassengerId  Survived  Pclass  Name  Age  SibSp  Parch  Ticket  Fare  Cabin  Embarked
Sex
female          314       314     314   314  261    314    314     314   314     97       312
male            577       577     577   577  453    577    577     577   577    107       577
总结
根据Sex对数据进行分组,然后对每一组的每一列进行统计。如果列中有数据缺失,则不统计,所以Age列的值时261,比其他列314少
分组统计总数(统计指定列)
上面的例子统计每一列,而实际的应用中,要统计指定的列,比如 只统计Name列
import pandas as pd
f=open(r'C:\Users\mym\Desktop\数据挖掘\titanic\train.csv','r')
df=pd.read_csv(f)
dfgb=df.groupby(by='Sex')
print(dfgb['Name'].count())
结果如下:
Sex
female    314
male      577
Name: Name, dtype: int64
获取统计后的数量
上例中,只是显示男女数量,但实际应用中,要获取男女的数量,然后用于后面的运算,比如计算男女比例
import pandas as pd
f=open(r'C:\Users\mym\Desktop\数据挖掘\titanic\train.csv','r')
df=pd.read_csv(f)
dfgb=df.groupby(by='Sex')
sex_count=dfgb['Name'].count()

female_count=sex_count['female']
male_count=sex_count['male']

print(female_count)
print(male_count)
print(female_count/(female_count+male_count)*100,'%')
last() 最后一个值
得到某列最后一个值(非NA)
需要用到数据集:SELL.csv,文件格式如下:
根据 Sell_No 分组,求 _Time 列的最后一天
import pandas as pd

df = pd.read_csv("SELL.csv", index_col=[0])
dfgb=df.groupby(by='Sell_No')
dfgb["_Time"].last()
first() 第一个值
得到某列第一个值(非NA)
用法类似last()