介绍
提示:为了便于理解,这里实现一个简化的自注意力机制,即:不包含 可训练的权重
下图,显示了一个输入序列,记为 x,它由 T 个元素组成,分别表示为 x^{(1)} 到 x^{(T)}。这个序列通常代表文本(如一个句子),并且该文本已经被转换为词元嵌入。

上下文向量
自注意力机制的目标:为 每个输入元素 x^{(i)} 计算一个 上下文向量(context vector) z^{(i)},该向量结合了 所有输入元素的信息,可以理解为一种包含 序列中所有元素信息 的 嵌入向量,模型才能理解 句子中单词之间的关系和相关性
在上图中,计算了 输入元素 x^{(2)} 的上下文向量 z^{(2)}
计算 z^{(2)} 时,各个输入元素的重要性或贡献度由注意力权重 a_{21} 到 a_{2T} 决定。这些注意力权重是针对输入元素 x^{(2)} 及其他所有输入元素计算的
例子
输入文本 Your journey starts with one step. ,文本序列中的每个元素(如 x^{(1)} )都对应一个 d 维的 嵌入向量,该向量代表了一个特定的词元,比如 Your。在图中,这些输入向量被表示为 三维嵌入。
1.初始化数据
以 Your journey starts with one step. 为输入,为了简单好理解,已按照之前的方式嵌入为三维向量,如下代码:
import torch

inputs = torch.tensor(
  [[0.43, 0.15, 0.89], # Your     (x^1)
   [0.55, 0.87, 0.66], # journey  (x^2)
   [0.57, 0.85, 0.64], # starts   (x^3)
   [0.22, 0.58, 0.33], # with     (x^4)
   [0.77, 0.25, 0.10], # one      (x^5)
   [0.05, 0.80, 0.55]] # step     (x^6)
)
2. 计算注意力分数
第一步是计算 注意力分数(Attention Score),如下图的 w :

提示:上图由于空间有限,显示的前几个输入张量的数值是 截断 的,比如 0.87 被截断为 0.8。在这个截断版本中,单词 journey 和 starts 的嵌入可能会由于随机原因看起来相似。
计算过程
通过 点积计算 查询 x^{(2)} 与其他 所有输入元素 之间的 注意力分数 w(注意:为了减少视觉混乱,数值被截断为小数点后一位数字)
# 取出第2个输入元素的嵌入向量,即:journey的嵌入向量
query = inputs[1]
# 创建注意力分数变量(初始化空张量,一维,长度是6的数组)
attn_scores_2 = torch.empty(inputs.shape[0])
# 计算第2个元素,与其他所有输入元素之间的 注意力分数
for i, x_i in enumerate(inputs):
    attn_scores_2[i] = torch.dot(x_i, query)
    print(x_i, " * ", query, "=", attn_scores_2[i])
print("注意力分数:", attn_scores_2)
计算得到的注意力分数如下所示:
tensor([0.4300, 0.1500, 0.8900])  *  tensor([0.5500, 0.8700, 0.6600]) = tensor(0.9544)
tensor([0.5500, 0.8700, 0.6600])  *  tensor([0.5500, 0.8700, 0.6600]) = tensor(1.4950)
tensor([0.5700, 0.8500, 0.6400])  *  tensor([0.5500, 0.8700, 0.6600]) = tensor(1.4754)
tensor([0.2200, 0.5800, 0.3300])  *  tensor([0.5500, 0.8700, 0.6600]) = tensor(0.8434)
tensor([0.7700, 0.2500, 0.1000])  *  tensor([0.5500, 0.8700, 0.6600]) = tensor(0.7070)
tensor([0.0500, 0.8000, 0.5500])  *  tensor([0.5500, 0.8700, 0.6600]) = tensor(1.0865)
注意力分数: tensor([0.9544, 1.4950, 1.4754, 0.8434, 0.7070, 1.0865])
点积
上面计算用到 点积,点积不仅被视为一种将两个向量转化为标量值的数学工具,而且也是度量相似度的一种方式,因为它可以量化两个向量之间的对齐程度:点积越大,向量之间的对齐程度或相似度就越高。
在自注意机制中,点积决定了序列中每个元素对其他元素的关注程度:点积越大,两个元素之间的相似度和注意力分数就越高。
res = 0
for idx, element in enumerate(inputs[0]):
    res += inputs[0][idx] * query[idx]
print("点积结果:", res)
print("点积结果:", torch.dot(inputs[0], query))
执行结果:
点积结果: tensor(0.9544)
点积结果: tensor(0.9544)
提示: torch.dot() 用法详见链接
归一化

对上面计算的每个注意力分数进行 归一化 处理。
目的:是获得 总和为1 的注意力权重。这种归一化是一个惯例,有助于解释结果,并能维持大语言模型的训练稳定性。
简单实现归一化
以下是一种实现这一归一化步骤的 简单方法:
attn_weights_2_tmp = attn_scores_2 / attn_scores_2.sum()
print("注意力权重:", attn_weights_2_tmp)
print("注意力权重sum:", attn_weights_2_tmp.sum())
执行结果:
注意力权重: tensor([0.1455, 0.2278, 0.2249, 0.1285, 0.1077, 0.1656])
注意力权重sum: tensor(1.0000)
softmax实现归一化
通过上面可知,目的 是获得 总和为1 的注意力权重,softmax 函数可以实现 概率归一化,正好符合这一功能。
所以,在实际应用中,使用 softmax 函数进行归一化更为常见,而且是一种更可取的做法。这种方法更好地处理了极值,并在训练期间提供了更有利的梯度特性。
以下是用于归一化注意力分数softmax函数的基础实现:
print("\n\nsoftmax实现概率归一化------")
# softmax函数实现概率归一化
def softmax_naive(x):
    print("torch.exp(x):", torch.exp(x))
    # 由于是一维张量,所以此处不写dim=0也可以,如果多维则必设置
    print("torch.exp(x).sum(dim=0):", torch.exp(x).sum(dim=0))
    return torch.exp(x) / torch.exp(x).sum(dim=0)


attn_weights_2_naive = softmax_naive(attn_scores_2)
print("softmax实现概率归一化的权重:", attn_weights_2_naive)
print("softmax实现概率归一化后的和:", attn_weights_2_naive.sum())
执行结果:
softmax实现概率归一化的权重: tensor([0.1385, 0.2379, 0.2333, 0.1240, 0.1082, 0.1581])
softmax实现概率归一化后的和: tensor(1.)
使用torch.softmax()实现归一化
由于 softmax 是 指数运算,所以上面简单实现在处理 大输入值 或 小输入值 时可能会遇到数值稳定性问题,比如 溢出 和 下溢。
因此,在实践中建议使用PyTorch实现,该实现经过了 大量性能优化:
print("\n\ntorch.softmax()实现归一化------")
# 使用PyTorch函数实现
attn_weights_2 = torch.softmax(attn_scores_2, dim=0)
print("torch.softmax实现归一化后的权重:", attn_weights_2)
print("torch.softmax实现归一化后的权重和:", attn_weights_2.sum())
执行结果:
torch.softmax()实现归一化------
torch.softmax实现归一化后的权重: tensor([0.1385, 0.2379, 0.2333, 0.1240, 0.1082, 0.1581])
torch.softmax实现归一化后的权重和: tensor(1.)
3. 计算上下文向量
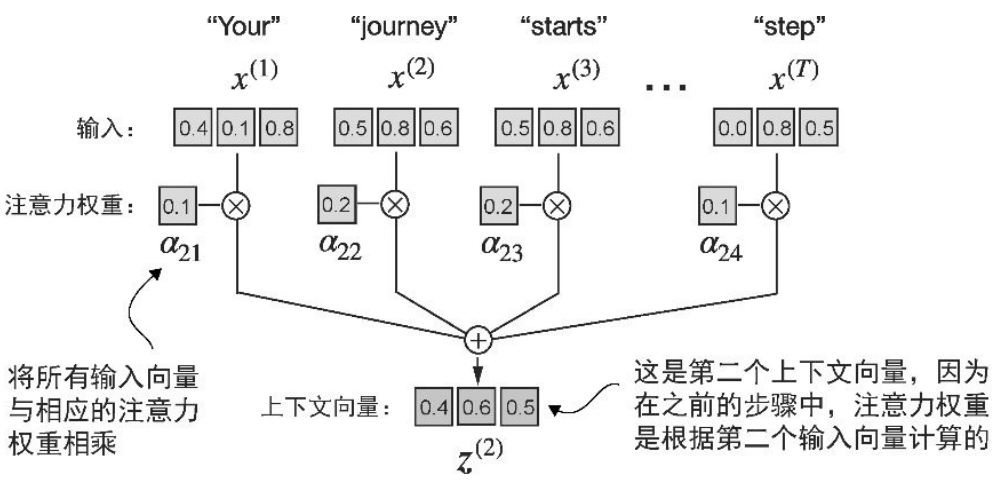
接下来计算上下文向量。如上图:
通过将嵌入的输入词元 x^{(2)} 与相应的注意力权重 相乘
再将得到的向量 求和来计算上下文向量 z^{(2)}
因此,上下文向量 z^{(2)} 是 所有输入向量的加权 总和,通过将每个输入向量与其对应的注意力权重相乘而获得
# 第二个输入词元作为查询向量
print("\n\n第二个输入词元作为查询向量------")
query = inputs[1]
context_vec_2 = torch.zeros(query.shape)
for i,x_i in enumerate(inputs):
    context_vec_2 += attn_weights_2[i]*x_i
print("上下文向量:", context_vec_2)
执行结果:
第二个输入词元作为查询向量------
上下文向量: tensor([0.4419, 0.6515, 0.5683])
计算所有输入词元的注意力权重
上面计算了 第二个输入词元 的注意力权重和上下文向量,如下图中突出显示的那一行

提示:图中的数值被截断为小数点后两位数,以减少视觉混乱。每行中的值加起来应为 1.0 或 100%
接下来,计算所有输入的注意力权重和上下文向量
计算过程
与之前的3个步骤相同,唯一的区别是在代码中进行了一些修改,以计算 所有上下文向量,如下图:

1.计算注意力分数
简单实现
为了便于理解,这里使用嵌套训练实现:
print("\n\n计算所有输入词元的注意力权重------")
attn_scores = torch.empty(6, 6)
for i, x_i in enumerate(inputs):
    for j, x_j in enumerate(inputs):
        attn_scores[i, j] = torch.dot(x_i, x_j)
print("所有输入词元的注意力分数:\n", attn_scores)
执行结果:
计算所有输入词元的注意力权重------
所有输入词元的注意力分数:
 tensor([[0.9995, 0.9544, 0.9422, 0.4753, 0.4576, 0.6310],
        [0.9544, 1.4950, 1.4754, 0.8434, 0.7070, 1.0865],
        [0.9422, 1.4754, 1.4570, 0.8296, 0.7154, 1.0605],
        [0.4753, 0.8434, 0.8296, 0.4937, 0.3474, 0.6565],
        [0.4576, 0.7070, 0.7154, 0.3474, 0.6654, 0.2935],
        [0.6310, 1.0865, 1.0605, 0.6565, 0.2935, 0.9450]])
pytorch矩阵乘法实现
使用Python中的 嵌套循环,数据量大时较慢,所以使用 pytorch 矩阵乘法 来得到相同的结果:
print("\n\npytorch矩阵乘法实现------")
attn_scores = inputs @ inputs.T
print("inputs @ inputs.T:\n", attn_scores)
或者
attn_scores = torch.matmul(inputs, inputs.T)
print("torch.multiply:\n", attn_scores)
两者计算方式完全相同,torch.matmul() 等价 @
执行结果:
 tensor([[0.9995, 0.9544, 0.9422, 0.4753, 0.4576, 0.6310],
        [0.9544, 1.4950, 1.4754, 0.8434, 0.7070, 1.0865],
        [0.9422, 1.4754, 1.4570, 0.8296, 0.7154, 1.0605],
        [0.4753, 0.8434, 0.8296, 0.4937, 0.3474, 0.6565],
        [0.4576, 0.7070, 0.7154, 0.3474, 0.6654, 0.2935],
        [0.6310, 1.0865, 1.0605, 0.6565, 0.2935, 0.9450]])
2. 归一化
对每一行进行归一化,以确保每一行中的值总和为1:
# 归一化
print("\n\n归一化------")
attn_weights = torch.softmax(attn_scores, dim=-1)
print("归一化后的权重:\n", attn_weights)
执行结果:
归一化------
归一化后的权重:
 tensor([[0.2098, 0.2006, 0.1981, 0.1242, 0.1220, 0.1452],
        [0.1385, 0.2379, 0.2333, 0.1240, 0.1082, 0.1581],
        [0.1390, 0.2369, 0.2326, 0.1242, 0.1108, 0.1565],
        [0.1435, 0.2074, 0.2046, 0.1462, 0.1263, 0.1720],
        [0.1526, 0.1958, 0.1975, 0.1367, 0.1879, 0.1295],
        [0.1385, 0.2184, 0.2128, 0.1420, 0.0988, 0.1896]])
验证每一行的和是否为1
print("\n\n验证每一行的和是否为1------")
row_2_sum = sum([0.1385, 0.2379, 0.2333, 0.1240, 0.1082, 0.1581])
print("第2行的和:", row_2_sum)
print("每一行的和:", attn_weights.sum(dim=1))
执行结果:
验证每一行的和是否为1------
第2行的和: 1.0
每一行的和: tensor([0.9220, 1.2970, 1.2788, 0.7974, 0.7540, 0.9508])
3. 计算上下文
最后一步,用这些注意力权重通过矩阵乘法计算出所有上下文向量:
print("\n\n计算所有上下文向量------")
all_context_vecs = attn_weights @ inputs
print("所有上下文向量:", all_context_vecs)
执行结果:
计算所有上下文向量------
所有上下文向量:
 tensor([[0.4421, 0.5931, 0.5790],
        [0.4419, 0.6515, 0.5683],
        [0.4431, 0.6496, 0.5671],
        [0.4304, 0.6298, 0.5510],
        [0.4671, 0.5910, 0.5266],
        [0.4177, 0.6503, 0.5645]])