需要掌握:大模型原理:实现简单自注意力机制(没有可训练权重)
介绍
在《 大模型原理:实现简单自注意力机制(没有可训练权重)》 中,实现了一个简化的注意力机制,以理解注意力机制背后的基本原理。
本文,在此基础之上,添加 可训练的权重:该权重在模型训练期间更新,这样模型(特别是模型内部的注意力模块)才能学会产生 “好的”上下文向量
下图展示了在实现整个大语言模型的过程中,自注意力机制是如何嵌入的:

概念:查询向量、键向量、值向量
查询向量(query)
用来在输入序列中查找相关信息的向量,代表了当前模型对于某一特定输出所需要关注的信息。
键向量(key)
用于与 查询向量 进行匹配的向量。每个输入序列的元素都会有一个键向量,表示该元素的 特征 或 信息。
值向量(value)
是与键(Key)向量对应的,用于生成最终的输出。
为什么需要 Query / Key / Value?
因为自注意力的核心思想是:
用 “查询(Query)” 去匹配 “键(Key)”,然后根据匹配程度取出相应的 “值(Value)”。
类比:
- Query = 你的问题
- Key = 每个文档的标题
- Value = 文档的内容
你用 “问题” 去匹配 “标题”,然后根据匹配度获取 “内容”。
工作过程?
自注意力的计算过程可以类比成“信息检索”:
- 每个位置生成 Q、K、V
- 用 Query 去和所有 Key 计算相似度(得分)
- 得分经过 Softmax 变成权重
- 用权重对 Value 加权求和 → 输出
公式:
score = Q * K^T
weights = softmax(score)
output = weights * V
直观例子
假设输入是三个词:
猫 喜欢 鱼
每个词都有一个输入向量 x。
经过 W_q、W_k、W_v 变换后得到:
猫: Q1, K1, V1
喜欢: Q2, K2, V2
鱼: Q3, K3, V3
当计算“喜欢”的输出时:
- Q2 会和 K1、K2、K3 分别计算相似度
- 假设 K3(鱼)和 Q2(喜欢)最相似 → 权重最高
- 于是“喜欢”的输出会重点包含 V3(鱼的信息)
这就是自注意力能捕捉语义关系的原因。
如何计算 查询向量、键向量、值向量
通过 输入向量 x 与 注意力权重 计算得到
注意力权重
3个 可训练 的权重矩阵 w_q、w_k 和 w_v,这3个矩阵用于与嵌入的输入词元 x^{(i)} 计算,得到 查询向量(query)、键向量(key)、值向量(value)
训练过程中,这些矩阵 会不断更新,让模型学会如何“匹配”和“取值”。
维度
在类GPT模型中,输入和输出的维度通常是相同的
计算过程

如图,将第二个输入元素 x^{(2)} 指定为查询输入,查询向量 q^{(2)} 是通过第二个输入元素 x^{(2)} 与权重矩阵 w_q 之间的 矩阵乘法 得到的。
查询向量(query)、键向量(key)、值向量(value)计算如下:
q^{(2)} = x^{(2)} * w_q
k^{(2)} = x^{(2)} * w_k
v^{(2)} = x^{(2)} * w_v
实现:计算第二个输入元素的q、k、v
1. 计算一个q、k、v
为了便于说明,只计算 第二个输入元素 的 上下文向量 z^{(2)}
import torch

inputs = torch.tensor(
    [[0.43, 0.15, 0.89],  # Your     (x^1)
     [0.55, 0.87, 0.66],  # journey  (x^2)
     [0.57, 0.85, 0.64],  # starts   (x^3)
     [0.22, 0.58, 0.33],  # with     (x^4)
     [0.77, 0.25, 0.10],  # one      (x^5)
     [0.05, 0.80, 0.55]]  # step     (x^6)
)

# 取出第2个嵌入向量,即:journey的嵌入向量
x_2 = inputs[1]
print("第2个嵌入向量x_2:", x_2)
# 输入嵌入维度d_in=3
d_in = inputs.shape[1]
# 输出嵌入维度d_out=2
d_out = 2

# 设置随机种子,方便复现结果
torch.manual_seed(123)
# 定义权重,3行2列。设置requires_grad=False以减少输出中的其他项,在模型训练中设置True
W_query = torch.nn.Parameter(torch.rand(d_in, d_out), requires_grad=False)
print("W_query:",W_query)
W_key = torch.nn.Parameter(torch.rand(d_in, d_out), requires_grad=False)
W_value = torch.nn.Parameter(torch.rand(d_in, d_out), requires_grad=False)

# 计算第2个嵌入向量的query查询向量、key键向量、value值向量
print("\n\n计算第2个嵌入向量的query查询向量、key键向量、value值向量")
query_2 = x_2 @ W_query
key_2 = x_2 @ W_key
value_2 = x_2 @ W_value
# x_2 是1行3列的矩阵,W_query是3行2列的矩阵,两个矩阵相乘的结果是1行2列
print("query_2:", query_2)
执行结果:
第2个嵌入向量x_2: tensor([0.5500, 0.8700, 0.6600])
W_query: Parameter containing:
tensor([[0.2961, 0.5166],
        [0.2517, 0.6886],
        [0.0740, 0.8665]])


计算第2个嵌入向量的query查询向量、key键向量、value值向量
query_2: tensor([0.4306, 1.4551])
2. 计算所有q、k、v
# 计算所有的query查询向量、key键向量、value值向量
print("\n\n计算所有的query查询向量、key键向量、value值向量")
querys = inputs @ W_query
keys = inputs @ W_key
values = inputs @ W_value
# x_2 是1行3列的矩阵,W_query是3行2列的矩阵,两个矩阵相乘的结果是1行2列
print("querys:", querys)
print("querys.shape:", querys.shape)
print("keys.shape:", keys.shape)
print("values.shape:", values.shape)
执行结果:
计算所有的query查询向量、key键向量、value值向量
querys: tensor([[0.2309, 1.0966],
        [0.4306, 1.4551],
        [0.4300, 1.4343],
        [0.2355, 0.7990],
        [0.2983, 0.6565],
        [0.2568, 1.0533]])
querys.shape: torch.Size([6, 2])
keys.shape: torch.Size([6, 2])
values.shape: torch.Size([6, 2])
计算第二个输入元素的注意力分数

为了便于理解,上图是计算 第二个元素 的注意力分数 w_{22}:将第二个元素的 查询向量,与各个元素的 键向量 进行 点积运算
计算w₂₂的注意力分数
# 计算w₂₂的注意力分数
print("\n\n计算w₂₂的注意力分数")
keys_2 = keys[1]
attn_score_22 = query_2.dot(keys_2)
print("w₂₂的注意力分数:", attn_score_22)
执行结果:
计算w₂₂的注意力分数
w₂₂的注意力分数: tensor(1.8524)
提示:还没有执行 归一化
计算 第二个元素的所有注意力分数
可以通过 矩阵乘法 将这个计算推广到所有的注意力分数
# 计算第2个元素的注意力分数
print("\n\n计算第2个元素的注意力分数")
attn_scores_2 = query_2 @ keys.T
print("keys.T:", keys.T)
print("第2个元素的注意力分数:", attn_scores_2)
执行结果:
计算第2个元素的注意力分数
keys.T: tensor([[0.3669, 0.4433, 0.4361, 0.2408, 0.1827, 0.3275],
        [0.7646, 1.1419, 1.1156, 0.6706, 0.3292, 0.9642]])
第2个元素的注意力分数: tensor([1.2705, 1.8524, 1.8111, 1.0795, 0.5577, 1.5440])
注意力分数转换为注意力权重

注意力权重计算步骤:
缩放注意力分数。这里是通过将注意力分数除以键向量的嵌入维度的平方根来进行缩放(取平方根在数学上等同于以0.5为指数进行幂运算)
使用 softmax函数 进行归一化
为什么缩放注意力分数
详见 链接
代码实现
# 注意力分数转换为注意力权重
print("\n\n注意力分数转换为注意力权重")
d_k = keys.shape[-1]
attn_weights_2 = torch.softmax(attn_scores_2 / d_k**0.5, dim=-1)
print("第2个元素的注意力权重:", attn_weights_2)
执行结果:
注意力分数转换为注意力权重
第2个元素的注意力权重: tensor([0.1500, 0.2264, 0.2199, 0.1311, 0.0906, 0.1820])
计算第二个输入元素的上下文向量
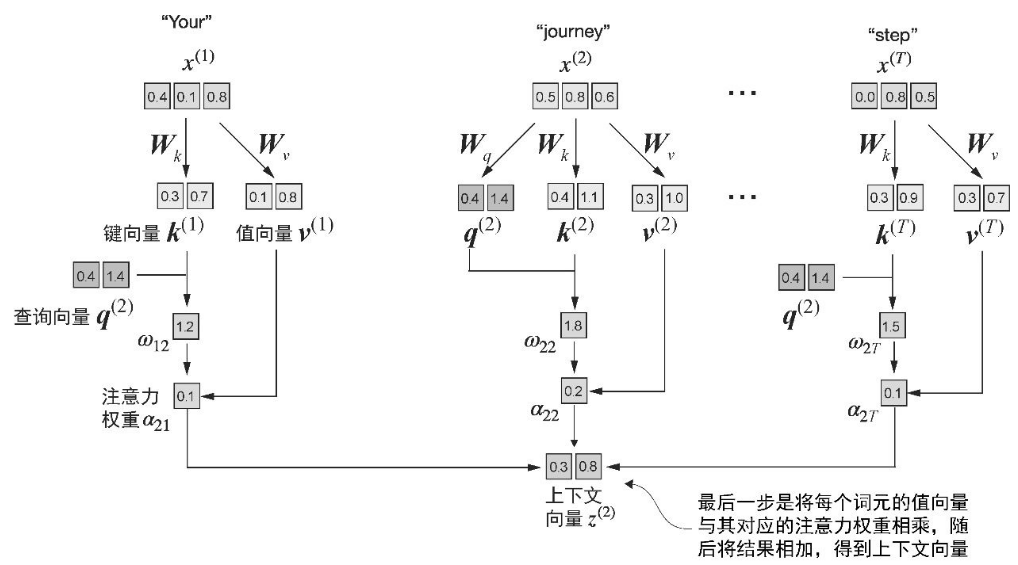
在这里,注意力权重 作为加权因子,用于权衡 每个值向量 的重要性。和之前一样,可以使用 矩阵乘法 一步获得输出结果:
# 计算上下文向量
print("\n\n计算上下文向量---------")
context_vec_2 = attn_weights_2 @ values
print("第2个元素的上下文向量:", context_vec_2)
执行结果:
计算上下文向量---------
第2个元素的上下文向量: tensor([0.3061, 0.8210])
到目前为止,我们只计算了一个上下文向量 z^{(2)}