说明
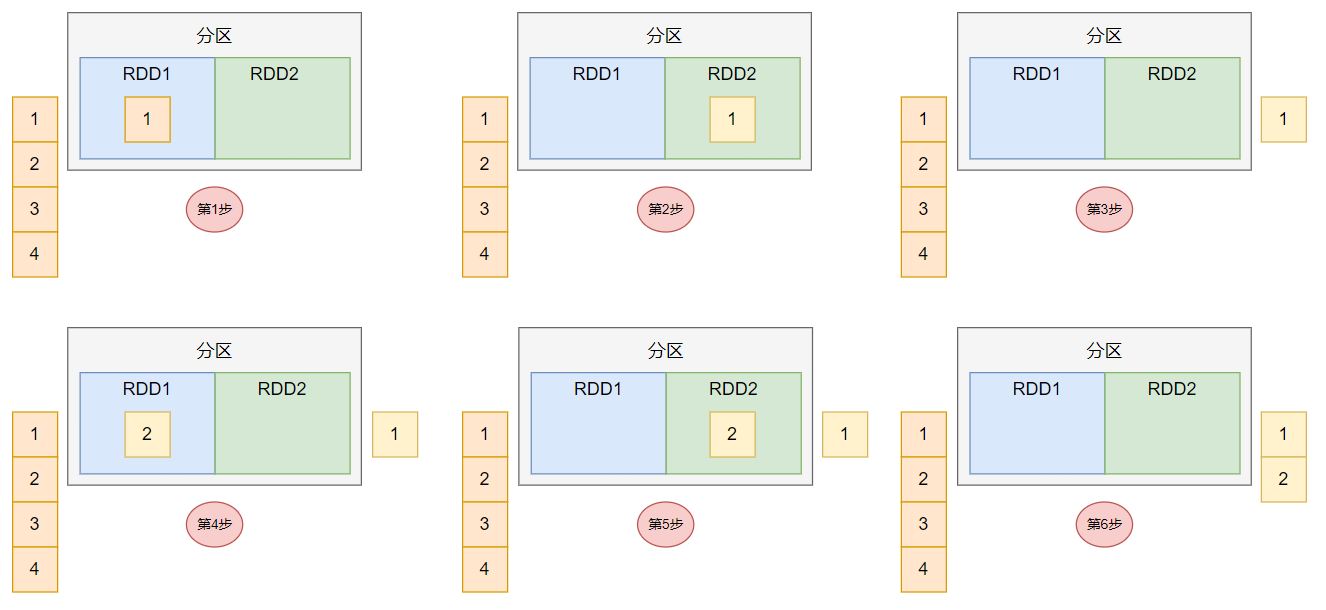
如下图:一个集合中的元素是:1,2,3,4,有2个RDD
一个分区
当只有一个分区时,是顺序执行的,即:第一个数据,送入第一个 RDD 执行,然后送入第二个RDD执行,全部RDD执行后,再计算下一个数据
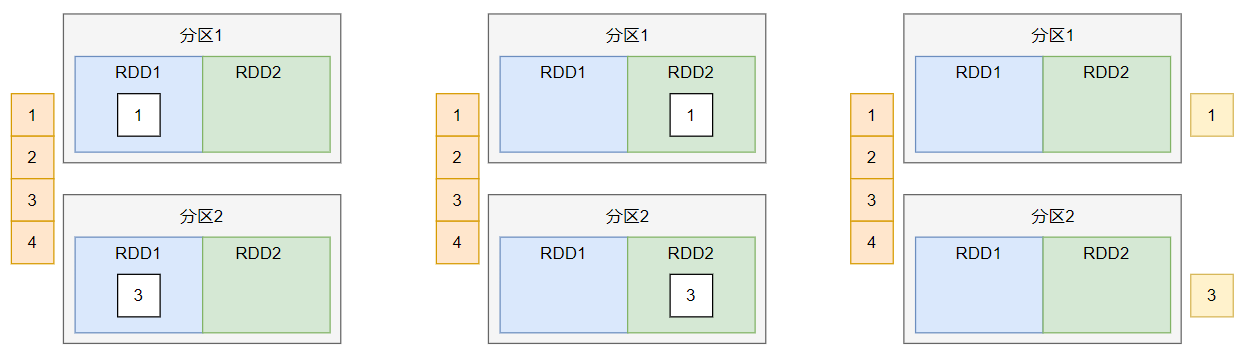
多个分区
当有多个分区时,多个分区可同时计算,是无序的,但每一个分区 是 顺序执行 的,同上
验证
一个分区
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)
//只有一个分区
val rdd: RDD[Int] = sc.makeRDD(List(1,2,3,4),1)
//    val rdd: RDD[Int] = sc.makeRDD(List(1,2,3,4),2)
val resRDD1 = rdd.map(e=>{
  println("RDD1::::"+e)
  e
})
val resRDD2 = resRDD1.map(e=>{
  println("RDD2::::"+e)
  e
})
resRDD2.collect()
sc.stop()
执行结果:
RDD1::::1
RDD2::::1
RDD1::::2
RDD2::::2
RDD1::::3
RDD2::::3
RDD1::::4
RDD2::::4
两个分区
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)
//只有一个分区
//    val rdd: RDD[Int] = sc.makeRDD(List(1,2,3,4),1)
val rdd: RDD[Int] = sc.makeRDD(List(1,2,3,4),2)
val resRDD1 = rdd.map(e=>{
  println("RDD1::::"+e)
  e
})
val resRDD2 = resRDD1.map(e=>{
  println("RDD2::::"+e)
  e
})
resRDD2.collect()
sc.stop()
执行结果:
RDD1::::1
RDD2::::1
RDD1::::3
RDD1::::2
RDD2::::3
RDD2::::2
RDD1::::4
RDD2::::4