说明
按照指定的排序规则,对数据进行排序,默认为升序排列。
相当于 scala集合中的 sortBy
排序后新产生的 RDD 分区数与原 RDD 的 分区数一致。
中间有 shuffle 过程,各个分区的数据 打乱了,各个分区数据的 数量 是 均衡的
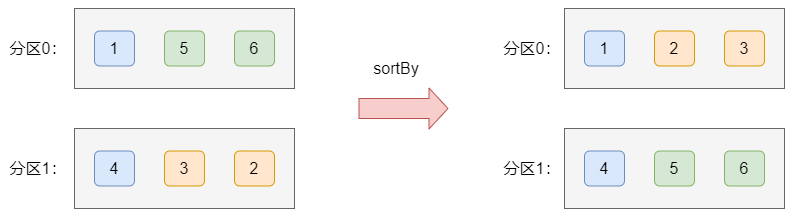
底层实现: 用 sortByKey()
应用场景
计算 TopN
声明
def sortBy[K](
      f: (T) => K,
      ascending: Boolean = true,
      numPartitions: Int = this.partitions.length)
参数:
- f:函数,排序规则
- ascending:升序,默认为true。设置 false表示降序
- numPartitions:分区数量
例子
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)

val rdd:RDD[Int] = sc.makeRDD(Array(1,5,6,4,3,2),2)

rdd.saveAsTextFile("res")

val resRDD: RDD[Int] = rdd.sortBy(e => e)

resRDD.saveAsTextFile("res2")
sc.stop()
通过执行结果可知,执行 sortBy 后,新产生的 RDD 分区数与原 RDD 的 分区数一致,各个分区的数据不同,数量均衡,经过 shuffle 打乱数据
案例
根据tuple的第2个元素进行排序
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)

val rdd:RDD[(String,Int)] = sc.makeRDD(List(("李雷",1),("韩梅梅",5),("lucy",6),("lili",4)),2)

rdd.saveAsTextFile("res")

//根据tuple的第2个元素进行排序
val resRDD: RDD[(String,Int)] = rdd.sortBy(_._2)

resRDD.saveAsTextFile("res2")
sc.stop()
对字符串型的数字进行排序
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)
//设置1个分区,如果多个分区,会并行打印,顺序是乱的
val rdd:RDD[String] = sc.makeRDD(List("1","2","18","112"),1)

rdd.foreach(println)

println("===========")
//字典排序
val resRDD: RDD[String] = rdd.sortBy(e => e)
//转成数字排序
//val resRDD: RDD[String] = rdd.sortBy(e => e.toInt)

resRDD.foreach(println)
sc.stop()