说明
将 数据 按照指定 规则 重新进行分区。
注意: RDD的泛型是map类型 [()],才能调用 .partitionBy()
分区器
HashPartitioner,默认的分区器
RangePartitioner
与coalesce、repartition区别
详见:spark partitionBy、coalesce、repartition算子区别
例子
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)


val rdd:RDD[Int] = sc.makeRDD(List(1,2,3,4,5))

//转换成 map泛型
val mapRDD:RDD[(Int,Int)]=rdd.map((_,1))
//map泛型的RDD才能调用partitionBy
val resRDD:RDD[(Int,Int)]=mapRDD.partitionBy(new HashPartitioner(2))

resRDD.saveAsTextFile("res")
sc.stop()
执行结果:
将 2、4放到分区0中,1、3、5放到分区1中
HashPartitioner 分区原理

查看 HashPartitioner.getPartition()源代码可知,底层实现是 key.hashCode % 分区数量
验证
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)


val rdd:RDD[Int] = sc.makeRDD(List(1,2,3,4,5))

//转换成 map泛型
val mapRDD:RDD[(Int,Int)]=rdd.map((_,1))
//map泛型的RDD才能调用partitionBy
val resRDD:RDD[(Int,Int)]=mapRDD.partitionBy(new HashPartitioner(2))

for( item <- Array(1,2,3,4,5)){
  val hashcode=item.hashCode()
  //打印数组元素、元素的hashcode,对分区数取模的结果
  println(item+",hashcode:"+hashcode+",partition:"+(hashcode % 2))
}

resRDD.saveAsTextFile("res")
sc.stop()
执行结果如下:
1,hashcode:1,partition:1
2,hashcode:2,partition:0
3,hashcode:3,partition:1
4,hashcode:4,partition:0
5,hashcode:5,partition:1
可知:
数组中第一个元素
1的hashcode值是1,对2取模,结果为1,所以在1号分区,保存在1号文件中数组中第二个元素
2的hashcode值是2,对2取模,结果为0,所以在0号分区,保存在0号文件中下面以此类推
新分区器和之前 RDD 的分区器一样
当 新分区器 和之前 RDD 的分区器一样(此处的一样指:分区器的类 和 分区数量 都一样),那么返回 RDD本身,而不会创建新的RDD
源码
查看 partitionBy() 源码如下:
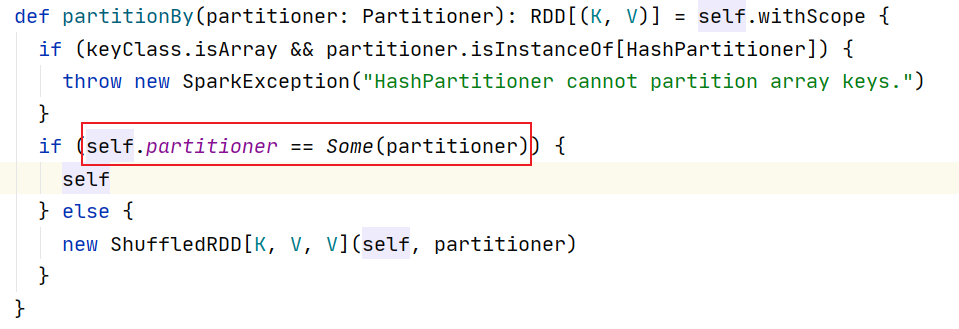
在这里调用 == 判断2个对象是否相同,如果相同就返回自己
== 底层实现是 equals 方法,查看其源码,如下:
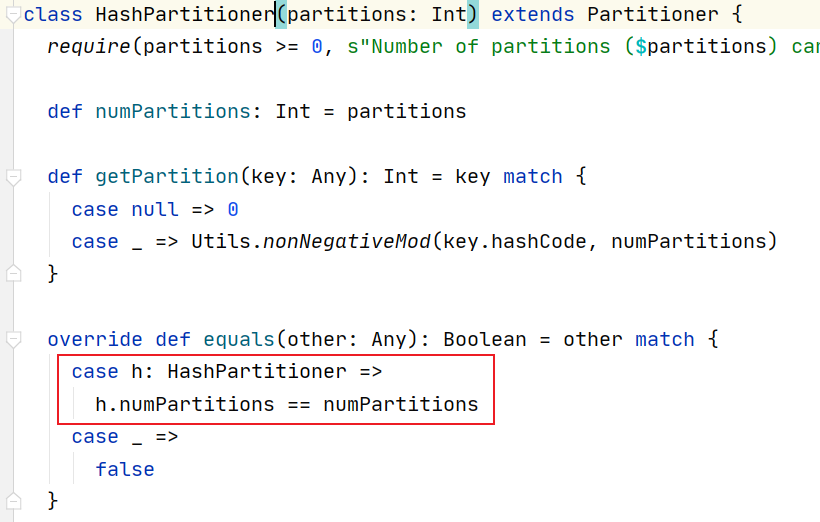
当 分区器 类型匹配,且 分区数量相同 时,就返回true
验证
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)


val rdd:RDD[Int] = sc.makeRDD(List(1,2,3,4,5))

//转换成 map泛型
val mapRDD:RDD[(Int,Int)]=rdd.map((_,1))
val resRDD:RDD[(Int,Int)]=mapRDD.partitionBy(new HashPartitioner(2))
val resRDD2:RDD[(Int,Int)]=resRDD.partitionBy(new HashPartitioner(2))

println(mapRDD == resRDD) // false
println(resRDD == resRDD2)  // true,说明没有创建新的RDD
resRDD2.collect()

sc.stop()