说明
按照相同的 Key 对 Value 进行 reduce 操作

注意: 分区内 和 分区间 的操作是相同的
声明
方法一
def reduceByKey(func: (V, V) => V): RDD[(K, V)]
形参:
- V:相同key的2个value
方法二
def reduceByKey(func: (V, V) => V, numPartitions: Int): RDD[(K, V)]
形参:
- V:相同key的2个value
- numPartitions:操作之后的partition数量,如:可合并成1个文件
方法三
def reduceByKey(partitioner: Partitioner, func: (V, V) => V): RDD[(K, V)]
形参:
- partitioner:分区器,如:
new HashPartitioner(1) - V:相同key的2个value
例子1
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)
val rdd = sc.makeRDD(Array(("李雷",2),("韩梅梅",3),("李雷",3)),2)
rdd.saveAsTextFile("res_reduceByKey")

//相同key的2个value进行聚合
val resRDD=rdd.reduceByKey((v1,v2) => v1+v2)

resRDD.saveAsTextFile("res_reduceByKey2")
sc.stop()
执行结果:
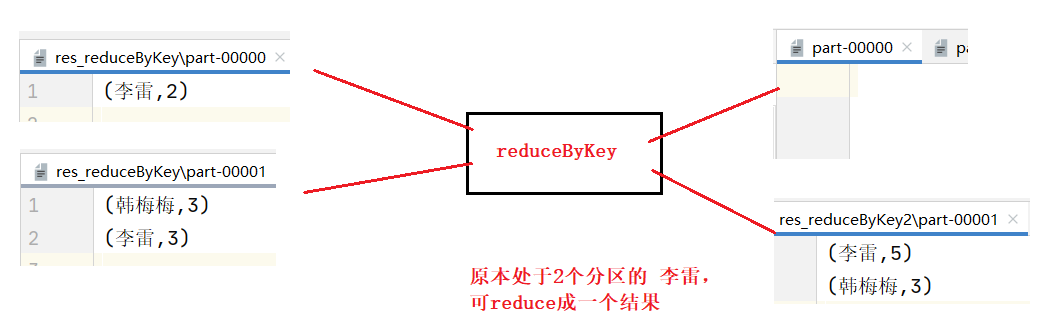
例子2
操作后合并成一个分区文件
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)
val rdd = sc.makeRDD(Array(("李雷",2),("韩梅梅",3),("李雷",3)),2)
rdd.saveAsTextFile("res_reduceByKey")

//相同key的2个value进行聚合,聚合后合并成1个分区文件
val resRDD=rdd.reduceByKey(_+_,1)

resRDD.saveAsTextFile("res_reduceByKey2")
sc.stop()
执行结果:
只有一个分区文件,内容如下:
(李雷,5)
(韩梅梅,3)