说明
相当于 SQL 中的
inner join
2个RDD 是 key-value,join后,返回的RDD是 key-value:
- key:RDD1 和 RDD2 相同的 key
- value:
- 相同key对应的value组合在一起
- 没有对应的key就丢弃
- 如果rdd内有相同的key,组合后可能有 笛卡尔积
图解
如下图:

注意
2个RDD中,不相同的key,就丢弃
例子
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)

val rdd1:RDD[(String,Int)] = sc.makeRDD(List(("李雷",182),("韩梅梅",169),("lili",170)))
val rdd2:RDD[(String,String)] = sc.makeRDD(List(("lucy","女"),("李雷","男"),("韩梅梅","女")))

val resRDD:RDD[(String,(Int,String))]=rdd1.join( rdd2)

resRDD.collect().foreach(println)
sc.stop()
笛卡尔积
2个RDD 有多个重复的 key,会依次匹配,出现笛卡尔积,数据量暴增,可能会内存溢出
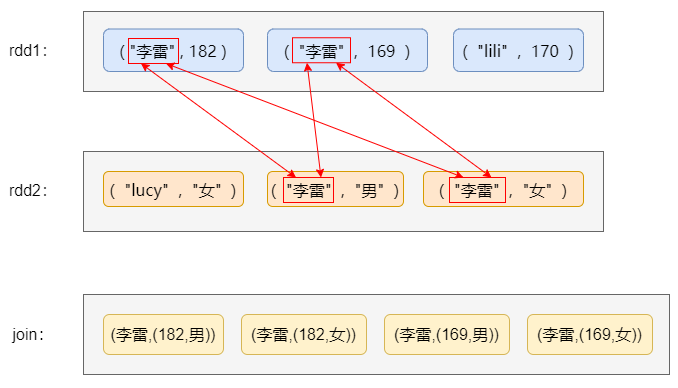
例子
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)

val rdd1:RDD[(String,Int)] = sc.makeRDD(List(("李雷",182),("李雷",169),("lili",170)))
val rdd2:RDD[(String,String)] = sc.makeRDD(List(("lucy","女"),("李雷","男"),("李雷","女")))

val resRDD:RDD[(String,(Int,String))]=rdd1.join( rdd2)

resRDD.collect().foreach(println)
sc.stop()