说明
相当于 SQL 中的
left join
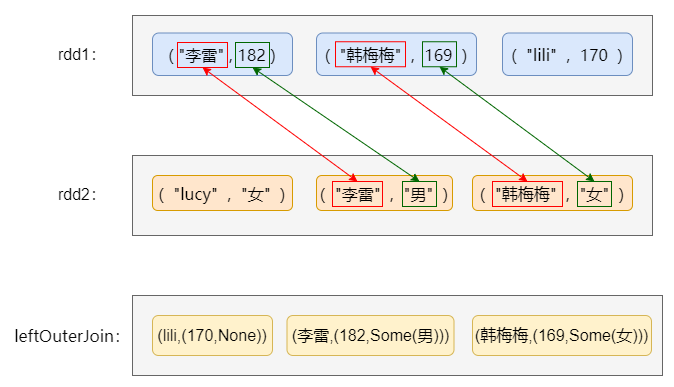
与 join() 类似,返回的RDD是 key-value:以 左侧 RDD 的key为主 ,将相同的key的value连接在一起,组成元祖,该元祖作为value,如下图:
注意
以 左侧 RDD 的key为主
例子
val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
val sc = new SparkContext(sparConf)

val rdd1:RDD[(String,Int)] = sc.makeRDD(List(("李雷",182),("韩梅梅",169),("lili",170)))
val rdd2:RDD[(String,String)] = sc.makeRDD(List(("lucy","女"),("李雷","男"),("韩梅梅","女")))

val resRDD:RDD[(String, (Int, Option[String]))]=rdd1.leftOuterJoin( rdd2)

resRDD.collect().foreach(println)
sc.stop()
执行结果:
(李雷,(182,Some(男)))
(韩梅梅,(169,Some(女)))
(lili,(170,None))
案例

有时需要对数据进行翻译
读取 HDFS 文本文件,返回 RDD1,数据如下:
("李雷", 1)
("韩梅梅", 2)
("lili", 3)
解释:第二个元素表示学历,需要对该值进行翻译,而该翻译的数据在 MySQL、redis 中,需要 spark 连接该数据库,查询的结果在 RDD2中,如下:
(1, "博士")
(2, "研究生")
(3, "本科")
翻译结果如下:
("李雷", "博士")
("韩梅梅", "研究生")
("lili", "本科")
代码:
def main(args: Array[String]): Unit = {
  val sparConf = new SparkConf().setMaster("local[*]").setAppName("RDD")
  val sc = new SparkContext(sparConf)
  val hiveRDD: RDD[(String, Int)] = sc.makeRDD(List(("李雷", 1), ("韩梅梅", 2), ("lili", 3), ("lucy", 4)))
  val mysqlRDD: RDD[(Int, String)] = sc.makeRDD(List((1, "博士"), (2, "研究生"), (3, "本科")))

  val hiveRDD2 = hiveRDD.map(e => (e._2, e._1))

  /*
  (Int, (String, Option[String]))
  Int:1、2、3
   (String, Option[String]):String是 人名,学历
   */
  val resRDD:RDD[(Int, (String, Option[String]))]=hiveRDD2.leftOuterJoin( mysqlRDD)

  val resRDD2 = resRDD.map(e => (e._2._1, e._2._2.getOrElse("未知")))
  resRDD2.foreach(println)


  sc.stop()
}