服务雪崩
分布式系统环境下,服务间类似依赖非常常见,一个业务调用通常依赖多个基础服务。如下图:
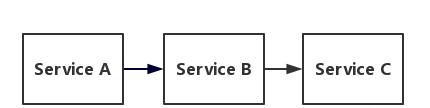
如果 service C 出现问题,将会导致 Service B 出现问题,也就会导致 Service A出现问题,如下图:
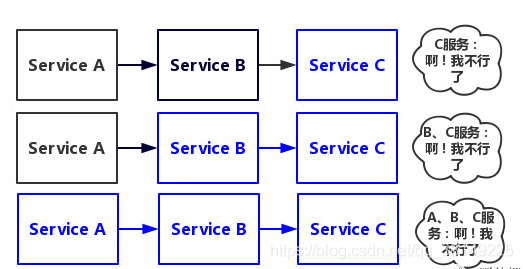
一个服务失败,导致整条链路的服务都失败的情形,称之为 服务雪崩
雪崩的原因
原因大致有四种:
- 硬件故障:如服务器宕机,机房断电,网络不通(大型机房成千上万台机器),光纤被挖断等
- 流量激增:如异常流量(当年鹿晗宣布恋情,微博热搜挂了)
- 缓存穿透、击穿(如redis 穿透、击穿)
- 程序Bug;
- 同步等待:服务间采用同步调用模式,同步等待造成的资源耗尽
案例:
当 Service A 的突发访问量很大(当年鹿晗宣布恋情,微博热搜挂了),即使 Service A 能扛得住请求,Service B 和 Service C 未必能扛得住这突发的请求。
此时,如果 Service C 因为抗不住请求,挂了 或者 响应极慢,那么 Service B 的请求也会 阻塞,慢慢耗尽 Service B 的线程资源,Service B 就会变得不可用。紧接着,Service A 也会不可用。
解决方案
- 硬件故障:多机房容灾、异地多活等
- 流量激增:服务自动扩容、流量控制(限流、关闭重试)等。
- 缓存穿透:缓存预加载、缓存异步加载等
- 程序BUG:修改程序bug、及时释放资源等
- 同步等待:资源隔离、MQ解耦、不可用服务调用快速失败等。资源隔离通常指不同服务调用采用不同的线程池;不可用服务调用快速失败一般通过熔断器模式结合超时机制实现。
- 服务降级
- 服务熔断
断路器
本身是一种开关装置,类似下图电闸,其主要功能就是 服务降级、服务熔断
服务降级

服务调用者 访问 服务提供者,当 服务提供者 因为某种原因不可用(如:超时无响应、抛异常),那么 服务调用者 主动调用本地的方法(Fallback方法),迅速返回给用户,避免卡顿!
Fallback方法可能返回信息:当前服务不可用 等等
应用方
应用在 服务调用者
降级方式
- 开关降级:使用动态配置,手动打开或者关闭降级开关。
- 限流降级:客户端访问量达到阈值后,调用降级处理
- 熔断降级:熔断器打开后,调用降级处理
服务熔断

注意:与服务降级类似,但又有区别
当 服务提供者 因为某种原因突然变得 不可用、抛异常 或 响应过慢,在一段时间内,达到一定比例,则触发 熔断:服务提供者 不在调用 原方法,而是直接调用 fallback方法。
如果 服务提供者 情况好转,则 恢复调用 原方法,不再调用 fallback方法。
熔断是框架级的处理,这套熔断机制的设计,一般是 断路器 模式
例子
在10s内,请求错误比例 >50% 时,该服务将进入熔断状态,即:在一段时间内,不再调用 原方法,直接调用 fallback方法
应用方
应用在 服务提供者
熔断的意义
本质上是为了 保护系统,让系统保持稳定,当 服务提供者 不可用时,服务调用者 仍能及时的返回响应
熔断器模式-基本模式
下图是断路器(Curcuit Breaker)的结构,它有两个基本状态(close 和 open)和一个基本 trip 动作:
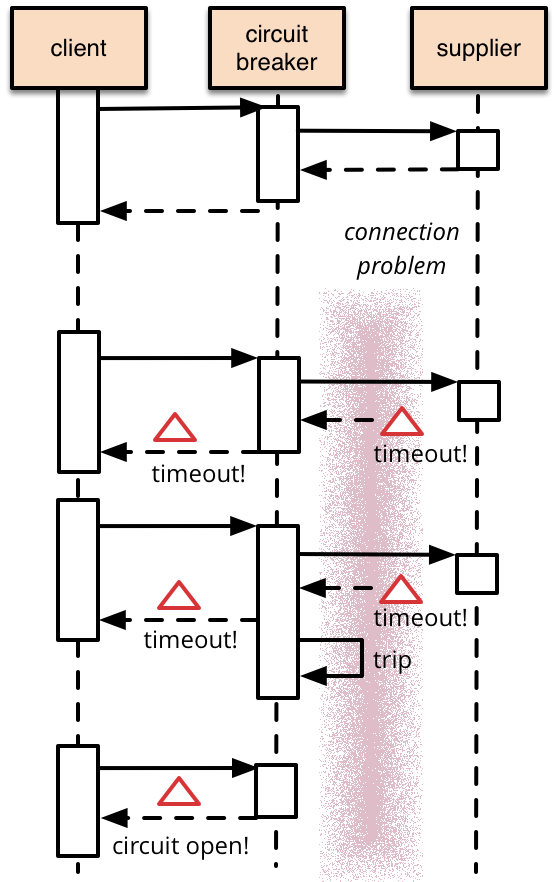
断路器 close状态, client向supplier发起的服务请求, 直接无阻碍通过断路器, supplier的返回值接直接由断路器交回给client.
trip: 断路器 close状态 下,如果supplier持续超时报错, 达到规定的 阀值 后,断路器就发生 trip, 之后断路器状态就会 从close进入open
断路器 open状态下,client向supplier发起的服务请求后,断路器不会将请求转到supplier, 而是 直接返回client, client和supplier之间的通路是 断的
缺点:基本模式保证了断路器在 open状态时,保护supplier不会被调用。但是,当supplier恢复服务后,断路器应该 进入close状态,允许 client 调用 supplier
熔断器模式-扩展模式
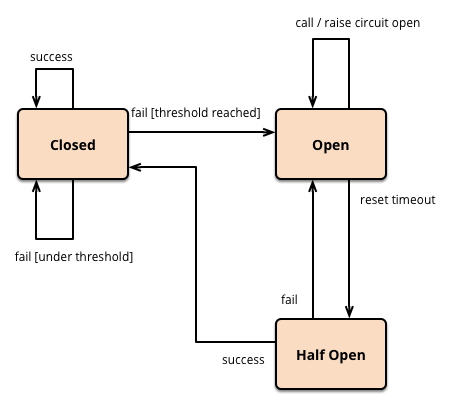
开始处于 closed状态,一旦检测到错误到达一定 阈值,便转为 open状态;
这时候会有个 reset timeout,到了这个时间了,会转移到 half open 状态;
尝试放行一部分请求,一旦检测 服务提供者 成功,断路器状态就会 从open进入close,即恢复服务;
熔断与降级的区别?
相同: 目的一致、表现类似、粒度一致
区别:触发条件不同,熔断一般是故障引起,降级一般是整体性能
解决方案
- Hystrix(停更)
- Sentinel(阿里)