提出问题
访问 http://hadoop1:19888/jobhistory
在历史服务web管理页面中,如下图:
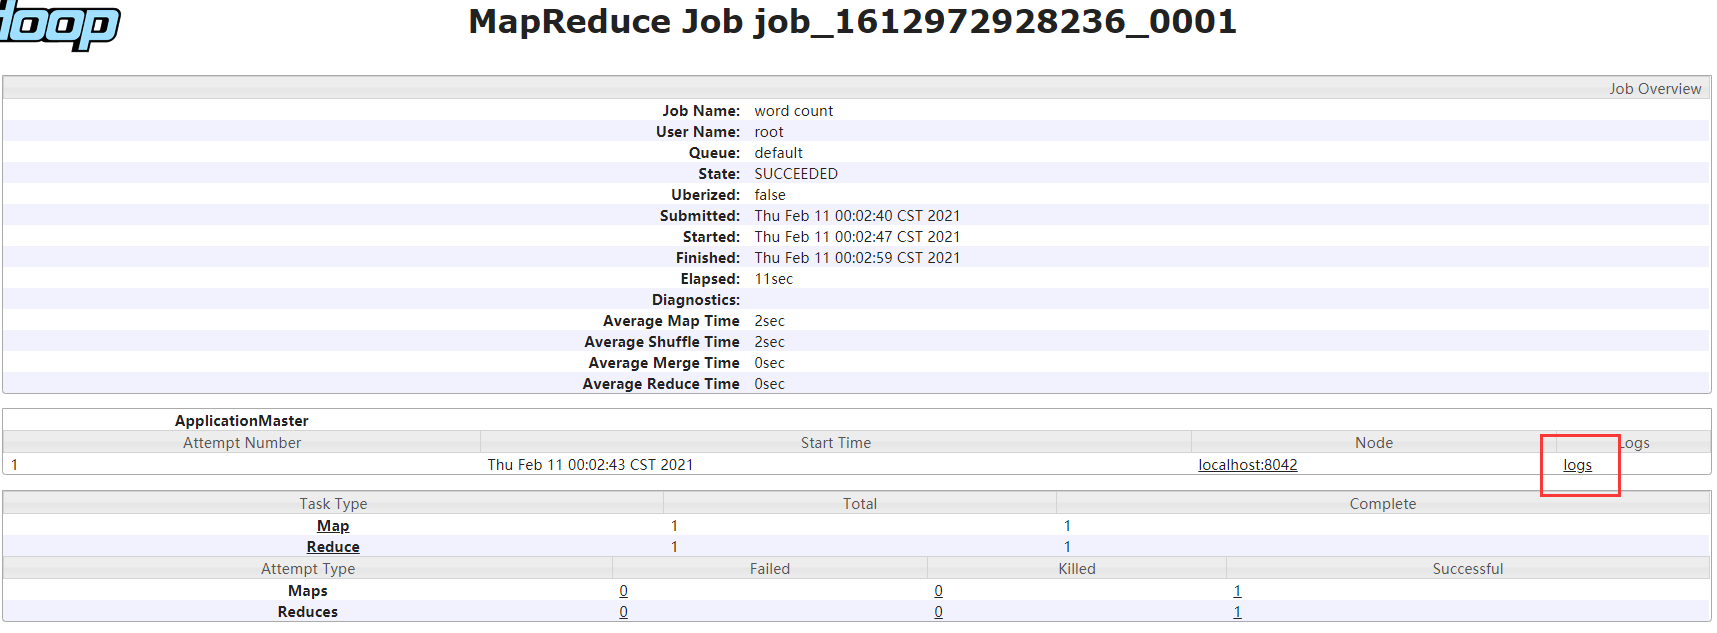
点击上图的 【logs】 ,显示界面如下:
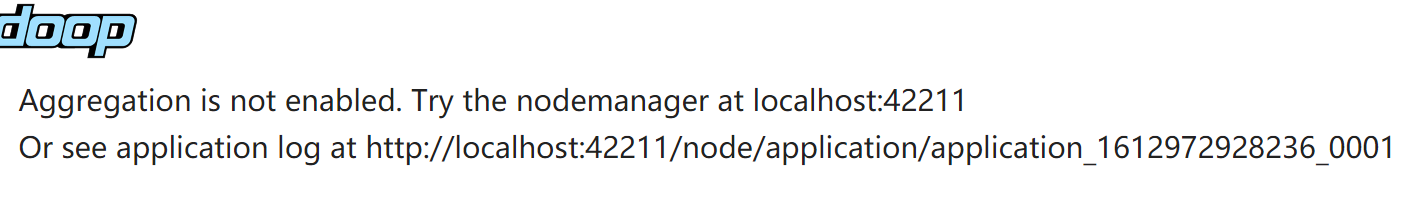
因为没有配置日志聚集服务
日志聚集
将程序运行 日志信息 上传到 HDFS 中
作用
便于查看到 程序运行详情,方便 开发调试。
修改 yarn-site.xml
进入 hadoop目录
cd /program/hadoop-3.0.3/etc/hadoop/
vim yarn-site.xml
vim yarn-site.xml
增加下面内容
<!-- 开启日志聚集功能 -->
<property>
    <name>yarn.log-aggregation-enable</name>
    <value>true</value>
</property>
<!-- 设置日志聚集服务器地址 -->
<property>
    <name>yarn.log.server.url</name>
    <value>http://hadoop1:19888/jobhistory/logs</value>
</property>
<!-- 设置日志保留时间为7天 -->
<property>
    <name>yarn.log-aggregation.retain-seconds</name>
    <value>604800</value>
</property>
解释: 时间单位:秒。604800秒/60/60/24=7天
同步文件
同步到 hadoop2
更新配置文件目录:
rsync -av /program/hadoop-3.0.3/etc/ root@hadoop2:/program/hadoop-3.0.3/etc
同步到 hadoop3
rsync -av /program/hadoop-3.0.3/etc/ root@hadoop3:/program/hadoop-3.0.3/etc
重启yarn
resourcemanager 部署在 hadoop2 上,所以 登录 hadoop2,执行下面命令:
stop-yarn.sh
start-yarn.sh
重启历史服务器
历史服务器部署在 hadoop1 上,登录 hadoop1,执行下面命令:
mapred --daemon stop historyserver
mapred --daemon start historyserver
执行统计词频
删除结果目录
如果有该目录,就先删除
hadoop fs -rm -r /result
启动程序
hadoop jar ${HADOOP_HOME}/share/hadoop/mapreduce/hadoop-mapreduce-examples-3.0.3.jar wordcount /test /result
web 查看日志聚集
入口一:
访问 http://hadoop1:19888/jobhistory

点击上图的 红框处,如下图:

点击上图的 【logs】 ,显示界面如下:
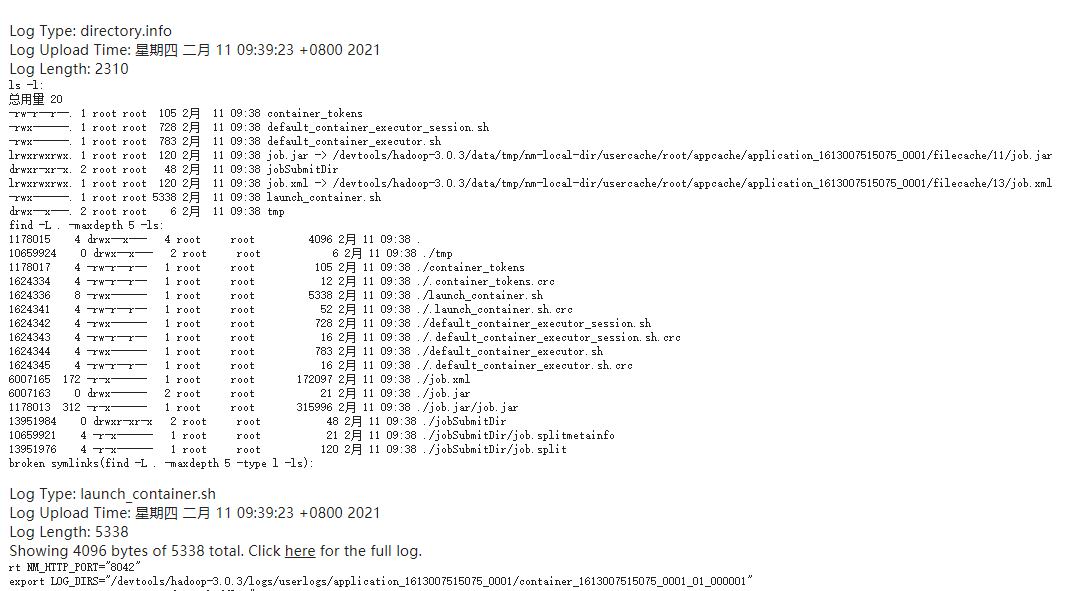
入口二:
访问:http://localhost:9870/ ,显示界面如下:

点击【history】,如下图:
点击上图的 【logs】 ,显示界面如下: