说明
HBase的导出工具是一个内置的实用功能,可以方便的 将导出数据文件,导入到另一个 hbase
其本质是一个 MapReduce 任务
注意: 该数据文件,必须是通过 Export 导出的数据文件,详见 点击
语法
hbase org.apache.hadoop.hbase.mapreduce.Import <tablename> <inputdir>
例子
将数据上传到hdfs中
方式一,通过 web 管理页面实现:
访问:http://hadoop1:9870/explorer.html#/
操作略
方式二,命令方式:
1.先将数据文件上传到linux
2.linux命令下,在 hdfs 上创建目录
hadoop fs -mkdir -p /import_data
3.linux命令下,将数据文件上传到hdfs上
hadoop fs -put /program/part-m-00000 /import_data
创建表
注意:创建表,该表的 列族,与数据文件中的 列族 必须相同
在 hbase shell 中先创建表:
create 'student2','info'
注意: 列族名必须与导入的数据相同
需要启动 yarn
导入数据是 MapReduce 程序,需要yarn,启动命令:
start-yarn.sh
执行导入
hbase org.apache.hadoop.hbase.mapreduce.Import student2 /import_data/part-m-00000
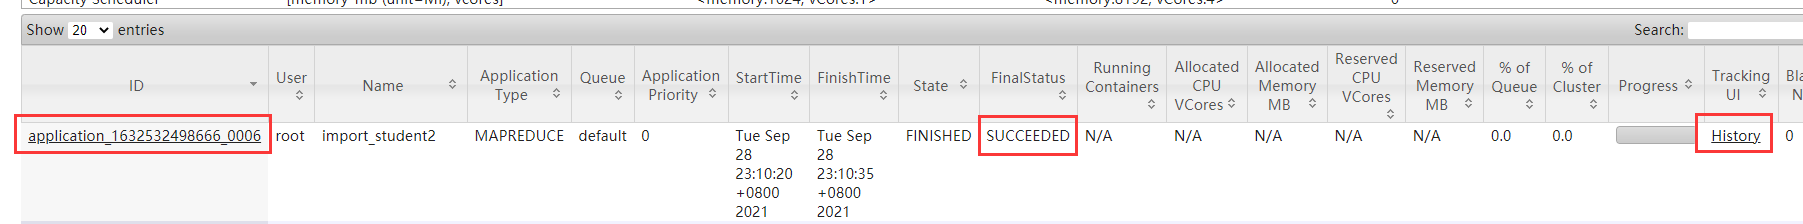
查看 yarn web管理页面
可以查看执行状态等信息,如下图:
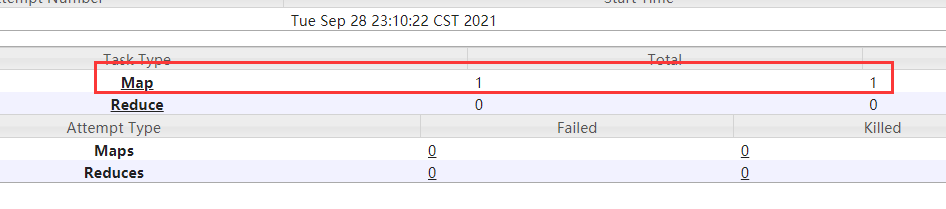
可以看到只有 map ,没有reduce,如下图:
查看数据
在 hbase shell 环境下,执行下面命令,查看:
scan 'student2'