shell 操作
手动设定预分区
Hbase> create 'student','info','info2',SPLITS => ['1000','2000','3000','4000']
解释:
info:列族名
0-1000是一个region1000-2000是一个region1000-3000是一个region3000-4000是一个region4000-是一个region
指定分区数量
create 'call_log','info',{NUMREGIONS => 3, SPLITALGO => 'HexStringSplit'}
解释:
info:列族名NUMREGIONS:分区数量HexStringSplit:rowkey 是 16 进制的字符串作为前缀
SPLITALGO 值可以是:
HexStringSplit:rowkey 是 16 进制的字符串作为前缀DecimalStringSplit:rowkey 是 10 进制的数字字符串作为前缀UniformStringSplit:rowkey 前缀是随机的。较少使用
按照文件中设置的规则预分区
创建 splits.txt 文件内容如下:
aaaa
bbbb
cccc
dddd
然后执行:
create 'student','info',SPLITS_FILE => 'splits.txt'
在 web 中查看
访问:http://hadoop1:16010/ ,如下操作
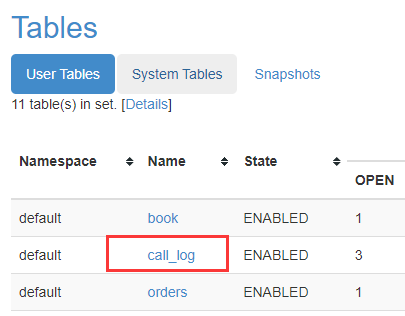
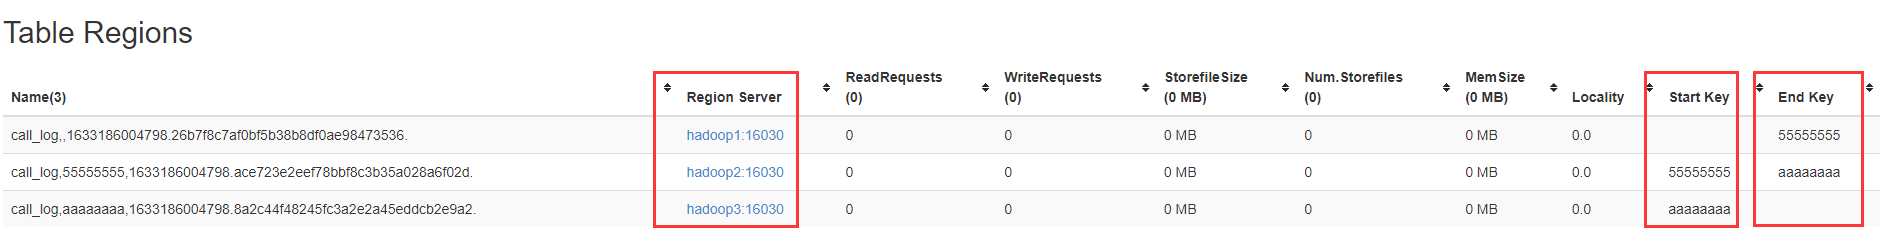
start key 和 end key 长度是 8 个字符
左开右闭,不包括左边的,包含右边的
JavaAPI 创建预分区
//自定义算法,产生一系列 hash 散列值存储在二维数组中
byte[][] splitKeys = 某个散列值函数
//创建 HbaseAdmin 实例
HBaseAdmin hAdmin = new HBaseAdmin(HbaseConfiguration.create());
//创建 HTableDescriptor 实例
HTableDescriptor tableDesc = new HTableDescriptor(tableName);
//通过 HTableDescriptor 实例和散列值二维数组创建带有预分区的 Hbase 表
hAdmin.createTable(tableDesc, splitKeys);