被 hbase2.1.x 预分区和rowkey设计操作 引用
说明
rowkey 设计的合理,能均匀的命中各个 region 的 rowkey 范围,就不会存在 写热点 问题
三大原则
rowkey长度原则
rowkey是一个 二进制 码流,可以是任意字符串,最大长度 64kb ,实际应用中一般为 10-100bytes,以 byte[] 形式保存,一般设计成 定长。
一般越短越好,长度不要超过 16个字节,注意原因如下:
- rowkey过长会很快占满
memstore,然后被 flush刷写到磁盘 - rowkey过长,影响
HFile的存储效率,存贮的内容被rowkey占据了一大部分,浪费
rowkey唯一原则
相当于主键,必须在设计上保证其唯一性
散列原则
见下面
热点问题
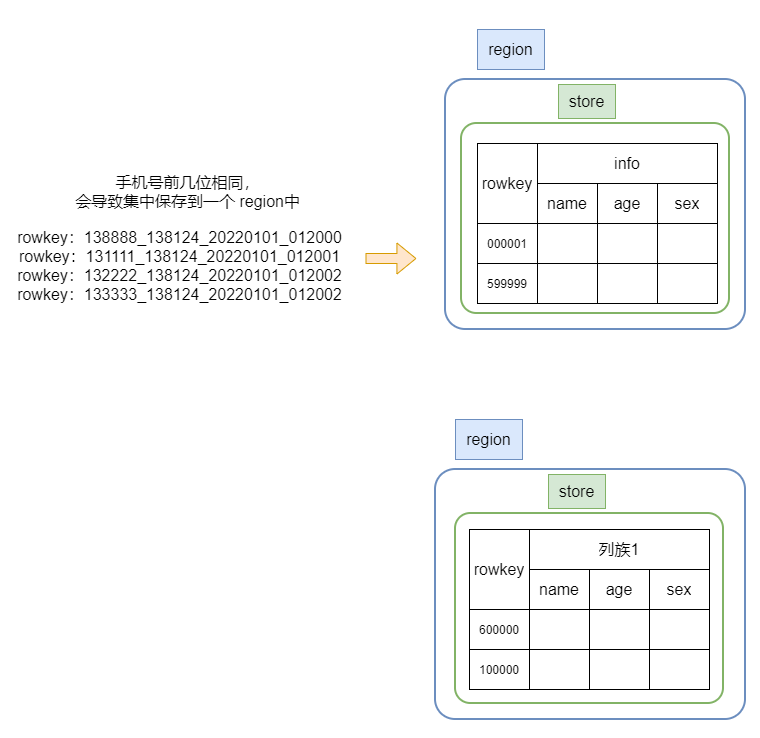
以电信公司的通话详单为例,如果 rowkey是:主叫手机号_被叫手机号_年月日时分秒,由于 手机号前 2 位 几乎相同的,那么所有通话记录,很大概率存储到同一台 region 中
在数据检索时,会集中在这台 RegionServer 上进行查询
读写都在这一台 region 中,就造成 热点问题,会降低查询效率,没有体现出 集群的性能
解决方法-哈希(散列值)
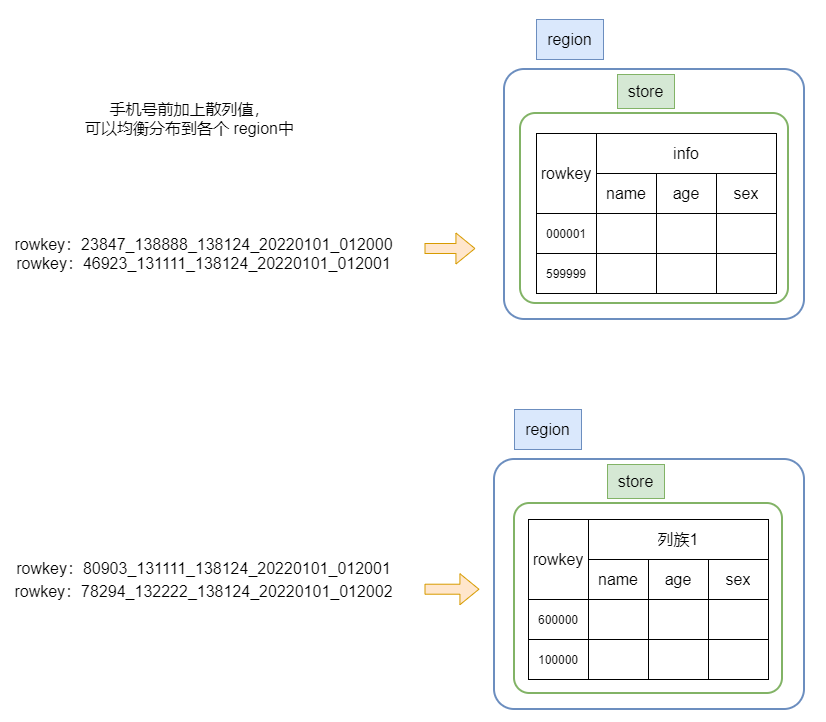
通过程序,根据 rowkey 算出 哈希值(散列值),该哈希值的 前缀是不相同的,可以认为是随机的。(但是,通过 rowkey 算出的 哈希值是固定的)
将 rowkey 的哈希值 拼接在 原始 rowkey 的前面,新 rowkey 的前缀就是不相同,可以提高数据 均衡分布 在各个 region 的几率
hash算法有 MD5 和 SHA-1
例子:
原rowkey:138888_139888_20220101093000
根据原 rowkey 算出 哈希值:823974152234 (假设)
新rowkey:823974152234_138888_139888_20220101093000
如下图:
解决方法-加盐
不是密码学中的加盐,而是在 rowkey 的前面增加 随机数,具体就是给 rowkey 分配一个 随机前缀 以使得它和之前的 rowkey 的开头不同。
解决方法-反转
对于 年月日、时分秒、手机号码,这样固定开头的 rowkey,其后几位都是随机的,没有规律的。
可以将其反转之后作为 rowkey,这样就避免了热点问题:
20170524000001 转成 10000042507102
20170524000002 转成 20000042507102
字典顺序
rowkey 是按照 字典顺序 排序存储的
好处:
设计 rowkey 的时候,要充分利用这个 排序的特点,可以将经常读取的数据存储到一块,将最近可能会被访问的数据放到一块。
注意: 量不能太大,如果太大需要拆分到多个节点上去
例子:
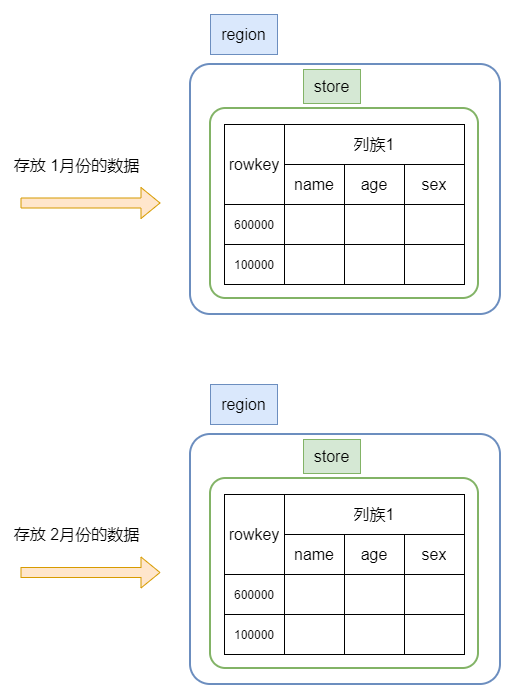
将用户的每个月订单,保存在同一个 region 中,查询时,从该 region 读取,可提高性能
此时就需要设计好 rowkey,添加数据时,将 用户 的1月订单 分到 同一个 region;将 用户 的2月订单 分到 另一个 region