说明
在Flink中,程序天生是 并行 和 分布式 的
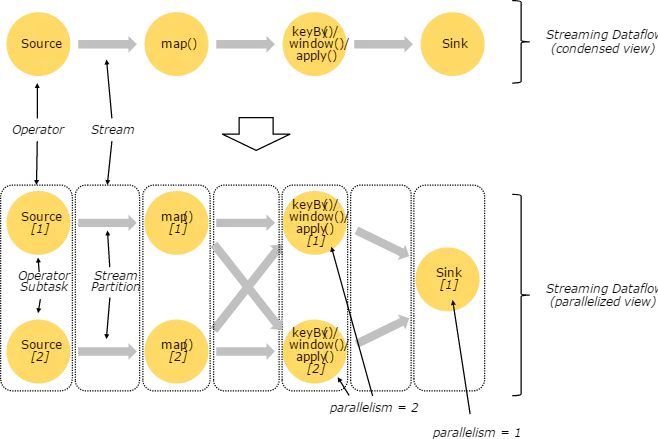
例子

Partition
一个Stream可以被分成多个 Stream 分区(Stream Partitions)
Subtask
一个 Operator 可以被分成多个 Operator Subtask ,多个分区任务可以并行,每一个 Subtask 是在不同的线程中独立执行的。
Parallelism
并行度,可以同时真正执行的 Subtask 的个数 或 Partition的个数
一个 Operator 的并行度,等于 Operator Subtask 的个数,一个 Stream 的并行度总是等于生成它的 Operator 的并行度。
2种模式
上图 Streaming Dataflow 的并行视图中,展现了在两个 Operator 之间的 Stream 的两种模式:
- one-to-one模式
- Redistribution模式
one-to-one模式
一个 source 对应 一个 map。
从 Source[1] 到 map()[1] ,它保持了 Source 的分区特性(Partitioning)和分区内元素处理的 有序性,也就是说 map()[1] 的 Subtask 看到数据流中记录的顺序,与 Source[1] 中看到的记录顺序是一致的。
Redistribution模式
这种模式改变了输入数据流的分区,一个上游的 map 可向 多个下游的 keyBy()/window()/apply() 发送数据。
比如:从 map()[1] 、 map()[2] 到 keyBy()/window()/apply()[1] 、 keyBy()/window()/apply()[2] ,上游的 Subtask 向下游的多个不同的 Subtask 发送数据,改变了数据流的分区,这与实际应用所选择的 Operator 有关系。
并行度
Source Operator 对应 2 个 Subtask,所以并行度为 2,而 Sink Operator 的 Subtask只有 1 个,故而并行度为 1 。
感谢:
https://blog.csdn.net/u012151684/article/details/108524576