Apache Flink 是一个框架和分布式处理引擎,用于在 无边界 和 有边界 数据流上进行有状态的计算。Flink 能在所有常见集群环境中运行,并能以内存速度和任意规模进行计算。
Apache Flink 擅长处理无界和有界数据集 精确的时间控制和状态化使得 Flink 的运行时(runtime)能够运行任何处理无界流的应用。有界流则由一些专为固定大小数据集特殊设计的算法和数据结构进行内部处理,产生了出色的性能。
处理无界和有界数据
任何类型的数据都可以形成一种事件流。信用卡交易、传感器测量、机器日志、网站或移动应用程序上的用户交互记录,所有这些数据都形成一种流。
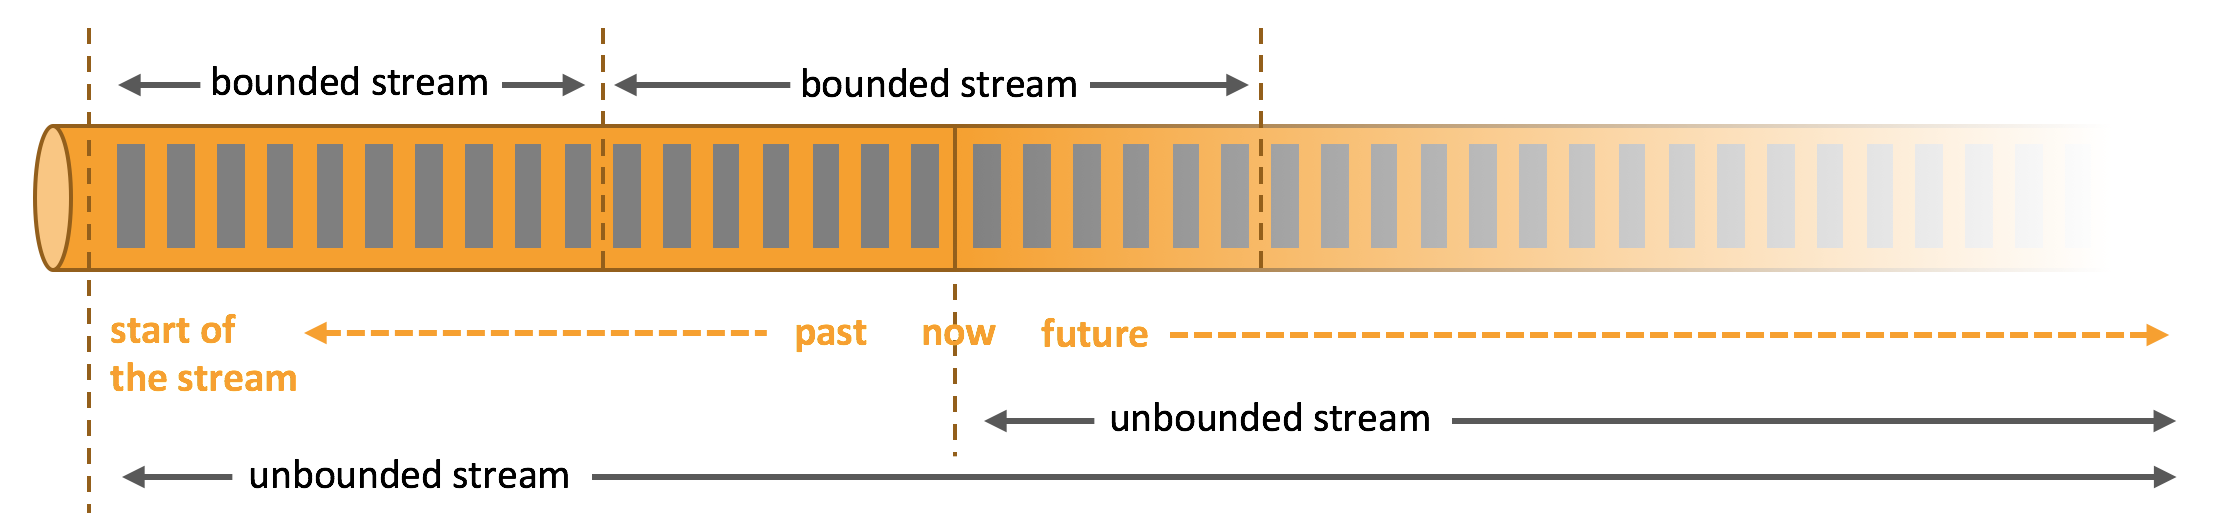
数据可以被作为 无界流 或者 有界流 来处理。
无界流 有定义流的开始,但没有定义流的结束。它们会无休止地产生数据。无界流的数据必须 持续处理,即数据被摄取后需要立刻处理。我们不能等到所有数据都到达再处理,因为输入是无限的,在任何时候输入都不会完成。处理无界数据通常要求以特定顺序摄取事件,例如事件发生的顺序,以便能够推断结果的完整性。
有界流 有定义流的开始,也有定义流的结束。有界流可以在摄取所有数据后再进行计算。有界流所有数据可以被排序,所以并不需要有序摄取。有界流处理通常被称为 批处理
批计算
统一收集数据 -> 存储到DB -> 对数据进行批量处理
如:MapReduce、hive、spark batch 等,对数据进行分析、处理、生成离线报表
流式计算
对 数据流 进行处理,
批计算 vs 流计算
数据时效性
流式计算:实时、低延时
批量计算:非实时、高延时
数据特征不同
流式计算:动态数据、没有边界。如:flink 连接 kafka,从kafka不断的发来数据
批量计算:静态数据
应用场景
流式计算:时效性比较高,如:实时推荐、智慧农业实时监控、金融实时风控
批量计算:多用在离线计算的场景,如:电信、信用卡月度账单、年度账单
运行方式
流式计算:其任务时持续进行的
批量计算:任务是一次性完成的