介绍
Flume是Cloudera提供的一个高可用的,高可靠的,分布式的 海量日志 采集、聚合 和 传输 的系统

一句话解释
是 数据传输软件,从 源 中读取数据,并写入到 目标 中
应用场景

三大功能:
定制各类数据发送方,用于收集数据
如:支持 从 文本文件、Kafka、TCP/UDP 中读取数据对数据进行简单处理
如:过滤数据将数据写到各种数据接受方(可定制)
如:将数据写入到 HDFS、Kafka、Hive
相关网站
中文翻译
https://flume.liyifeng.org/#
注意: 适用于日志文件,即:文本文件,二进制文件不支持
组成架构
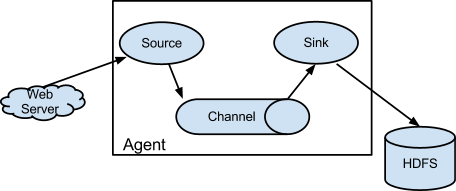
Agent
Agent 是一个 JVM 进程,它以事件的形式将数据从源头送至目的。
Agent 主要有 3 个部分组成:
- Source
- Channel
- Sink
Source
Source 是负责 读取数据 到 Flume Agent 的组件。
Source 组件可以处理各种类型、各种格式的日志数据,常用的有:
- taildir:文件
- Kafka:读取Kafka中的数据
- spooldir:监控某个目录下的新增文件
Sink
Sink 不断地轮询 Channel 中的 事件 且批量地移除它们,并将这些 事件 批量 写入 到 存储 或 索引 系统、或者 发送到另一个 Flume Agent。
写入目的地包括:
- hdfs:将数据保存到 hdfs
- hive:将数据保存到 hive 中
- logger:打印到控制台
- file:将数据写到 文件 中
- HBase:将数据保存到 HBase 中
- kafka:将数据保存到 kafka 中
Channel
Channel 是位于 Source 和 Sink 之间的 缓冲区。因此,Channel 允许 Source 和 Sink 运作在不同的速率上。
Channel 是线程安全的,可以同时处理几个 Source 的写入操作和几个Sink 的读取操作。
Flume 自带两种 Channel:
Memory Channel:内存中的队列。Memory Channel 在不需要关心数据丢失的情景下适用。如果需要关心数据丢失,那么 Memory Channel 就不应该使用,因为程序死亡、机器宕机或者重启都会导致数据丢失。
File Channel:将所有事件写到磁盘。因此在程序关闭或机器宕机的情况下不会丢失数据。
Event
传输单元,Flume 数据传输的基本单元,以 Event 的形式将数据从源头送至目的地。
一行为一个Event
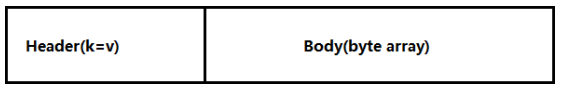
Event 由 Header 和 Body 两部分组成,Header 用来存放该 event 的一些属性,为 K-V 结构,Body 用来存放该条数据,形式为字节数组。
目录结构
bin:启动命令
conf:配置文件,创建任务的模板文件
lib:jar包