架构
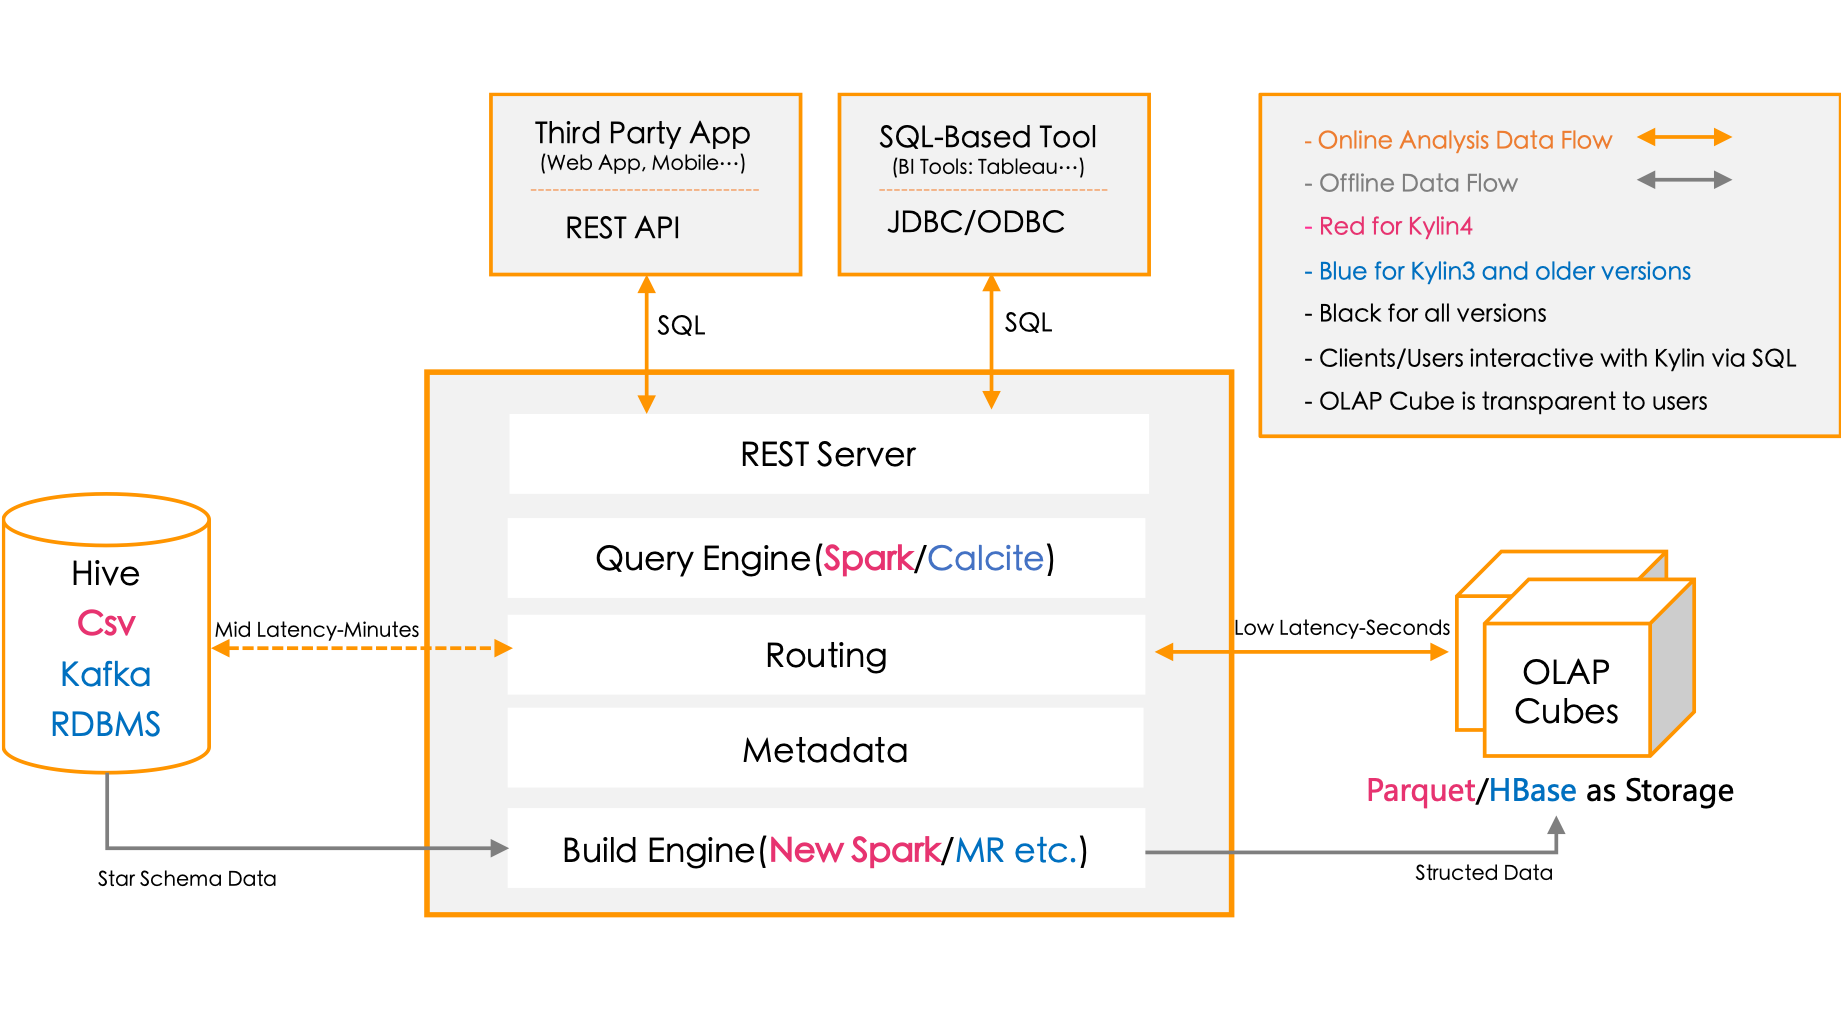
数据源
主要是Hive、Kafka
REST Server
提供一些restful接口,对 project、Models、cube 等元数据管理、用户访问权限、系统配置动态修改等。除此之外还可以通过该接口实现 SQL 的查询,这些接口一方面可以通过第三方程序的调用,另一方也被kylin的web界面使用。
jdbc/odbc接口
kylin提供了jdbc的驱动,使用 jdbc 接口的查询走的流程和使用RESTFul接口查询走的内部流程是相同的。
Query引擎
kylin使用一个开源的Calcite框架实现SQL的解析,相当于SQL引擎层。
Routing
该模块负责将解析 SQL 生成的执行计划,转换成cube缓存的查询,查询以 秒级、毫秒级完成
Metadata
kylin中有大量的元数据信息,包括cube的定义,星状模型的定义、job的信息、job的输出信息、维度的directory信息等等,元数据和cube都存储在hbase中,存储的格式是json字符串
Build Engine(构建引擎)
是所有模块的基础,负责预计算创建cube,创建的过程是通过hive读取原始数据,然后通过一些 mapreduce 或 spark 计算
然后保存到 hbase
存储(Storage Engine)
存储引擎使用的是HBase
原理
Kylin的核心思想是 预计算
以空间换时间,即多维分析可能用到的度量进行 预计算,将计算好的 结果保存成Cube并存储到 HBase 中,供查询时直接访问。
流程
预计算
将数据源(如Hive)中的数据按照指定的 维度 和 指标,由计算引擎 mapreduce 或 spark 离线计算出 所有可能的查询结果 (即Cube)
存储
将上面的查询结果,存储到HBase中
HBase中每行记录的 rowkey 由各维度的值拼接而成,度量会保存在column family 中
查询
利用 HBase 列存储的特性,可以提供 快速响应 和 高并发 的查询