说明
维度数据模型,根据 事实表 和 维度表 的 关系,分为 星型模型 和 雪花型模型。
在设计时,就应考虑数据是按照星型模型还是雪花型模型进行组织。
星型模型
是维度数据模型 最简单 的形式,也是最广泛的形式。
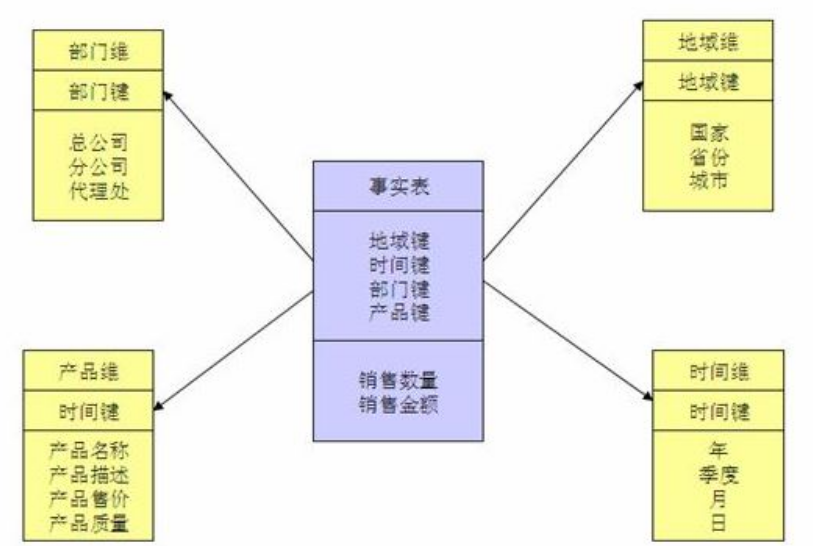
星型模型由事实表和维度表组成,有一张事实表,以及一个或多个维度表;事实表与维度表通过主键外键相关联,维度表与维度表之间没有关联,所有维表都直接连接到 “事实表”
如下图,中心是一个事实表,周围是维度表,像星星呈放射状:
优点
星型模型因为数据的冗余所以很多统计查询不需要做外部的连接,因此一般情况下效率比雪花型模型要高
- 简化查询。查询数据时,星型模式的连接逻辑比较简单,而从高度规范化的事务模型查询数据时,往往需要更多的表连接。
- 简化业务报表逻辑。与高度规范化的模式相比,由于查询更简单,因此星型模式简化了普通的业务报表(如每月报表)逻辑。
- 获得查询性能。星型模式可以提升只读报表类应用的性能。
- 快速聚合。基于星型模式的简单查询能够提高聚合操作的性能.
缺点
星型架构是一种非正规化的结构,多维数据集的每一个维度都直接与事实表相连接,不存在渐变维度,所以数据有一定的冗余,
如在地域维度表中,存在下面两条记录,那么 吉林省 和 长春市 的信息分别 存储了两次,即 存在冗余
| 省 | 市 | 县 |
|---|---|---|
| 吉林省 | 长春市 | 农安 |
| 吉林省 | 长春市 | 榆树 |
应该继续拆分,然后做主外键关联
雪花模型
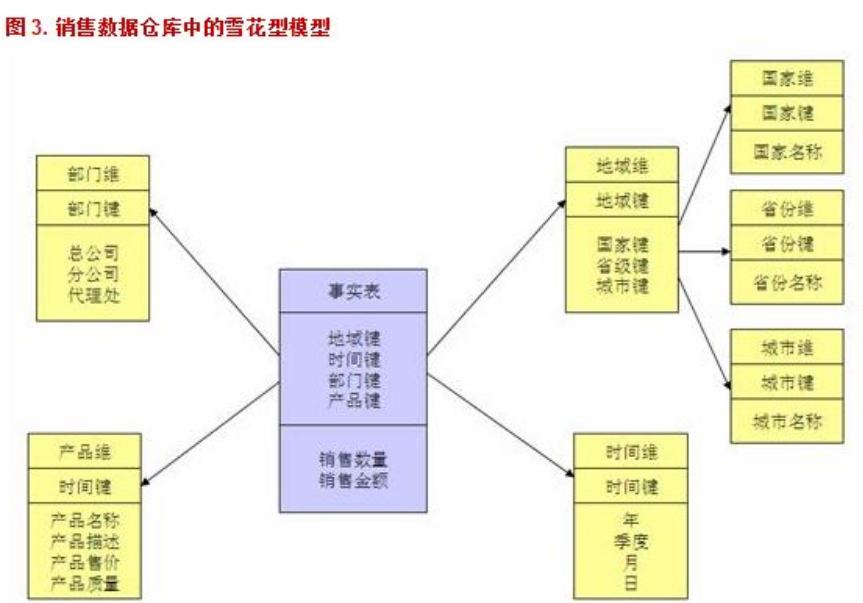
如果将星型模型中某些维度的表再做规范,抽取成更细的维度表,然后让维度表之间也进行关联,即:一个或多个维表没有直接连接到事实表上,而是通过其他维表连接到事实表
优点
将 地域维表 又分解为 国家,省份,城市 等维表。
优点是 : 通过最大限度地减少数据存储量以及联合较小的维表来改善查询性能。雪花型结构去除了数据冗余
缺点
雪花型模型由于去除了冗余,有些统计就需要通过表的联接才能产生,所以效率不一定有星型模型高
做关联查询时也更加复杂
星型模型 VS 雪花模型

数据优化
雪花模型使用的是 规范化数据,也就是说数据在数据库内部是组织好的,以便消除冗余,因此它能够有效地减少数据量。通过引用完整性,其业务层级和维度都将存储在数据模型之中
相比较而言,星形模型使用的是 反规范化数据。在星形模型中,维度直接指的是事实表,业务层级不会通过维度之间的参照完整性来部署
业务模型
在雪花模型中,数据模型的业务层级是由一个不同维度表 主键-外键 的关系来代表的。
在星形模型中,所有必要的维度表在事实表中都只拥有外键。
性能
雪花模型在维度表、事实表之间的连接很多,因此性能方面会比较低。
星形模型的连接就少的多,因此 性能方面比较好。
ETL
雪花模型加载数据集市,因此ETL操作在设计上更加复杂,而且由于附属模型的限制,不能并行化。
星形模型加载维度表,不需要在维度之间添加附属模型,因此ETL就相对简单,而且可以实现高度的并行化。
选择
在冗余可以接受的前提下,实际运用中 星型模型 使用更多,也更有效率。
更详细参见:
https://zhuanlan.zhihu.com/p/90223969