idea 安装 scala 插件
https://malaoshi.top/show_1IXnyD53SzF.html
创建工程


添加 scala 框架支持


创建scala源码文件夹


标记文件夹为源码

修改设置
必须按下图勾选,否则 使用 aggregateByKey() 算子时报错

错误如下:
org.apache.spark.SparkException: Task not serializable
pom.xml
添加依赖
<dependencies>
    <dependency>
        <groupId>org.apache.spark</groupId>
        <artifactId>spark-core_2.12</artifactId>
        <version>3.0.0</version>
    </dependency>
    <dependency>
        <groupId>org.apache.spark</groupId>
        <artifactId>spark-yarn_2.12</artifactId>
        <version>3.0.0</version>
    </dependency>
    <dependency>
        <groupId>org.apache.spark</groupId>
        <artifactId>spark-sql_2.12</artifactId>
        <version>3.0.0</version>
    </dependency>
</dependencies>
添加 scala 编译器插件
<build>
    <sourceDirectory>src/main/scala</sourceDirectory>
    <plugins>
        <plugin>
            <groupId>net.alchim31.maven</groupId>
            <artifactId>scala-maven-plugin</artifactId>
            <version>3.3.2</version>
            <executions>
                <execution>
                    <goals>
                        <goal>compile</goal>
                        <goal>testCompile</goal>
                    </goals>
                </execution>
            </executions>
        </plugin>
    </plugins>
</build>
log4j.properties
WARN 级别,是因为打印日志太多
log4j.rootLogger=WARN, stdout
log4j.appender.stdout=org.apache.log4j.ConsoleAppender
log4j.appender.stdout.layout=org.apache.log4j.PatternLayout
log4j.appender.stdout.layout.ConversionPattern=%d %p [%c] - %m%n
准备数据
在工程根目录下创建 cdz.txt 文件,内容如下:
- 第一列:充电桩ID
- 第二列:本次充电量
- 第三列:本次充电时长
- 第四列:开始充电时间
- 第五列:结束充电时间
1,100,10,2020-01-01 09:30:50,2020-01-01 09:40:50
2,200,25,2020-01-11 10:40:50,2020-01-11 11:05:50
3,150,12,2020-01-01 11:20:50,2020-01-01 11:32:50
1,300,50,2020-01-03 14:30:50,2020-01-03 15:20:10
1,50,5,2020-02-02 12:30:50,2020-02-02 12:35:50
2,500,50,2020-02-02 15:30:30,2020-02-02 17:20:30
3,150,12,2020-02-01 11:20:50,2020-02-01 11:32:50
3,150,12,2020-02-03 11:20:50,2020-02-03 11:32:50
1,100,10,2020-03-01 09:30:50,2020-03-01 09:40:50
1,100,10,2020-03-05 09:30:50,2020-03-05 09:40:50
2,500,120,2020-03-12 15:30:30,2020-03-12 17:30:30
2,500,120,2020-03-22 15:30:30,2020-03-22 17:30:30
3,400,50,2020-03-02 17:30:20,2020-03-02 18:20:20
4,100,5,2020-04-01 11:20:50,2020-04-01 11:25:50
4,50,8,2020-04-21 11:20:50,2020-04-21 11:28:50
5,150,12,2020-04-11 11:20:50,2020-04-11 11:32:50
6,150,20,2020-04-15 11:20:50,2020-04-15 11:40:50
创建scala文件
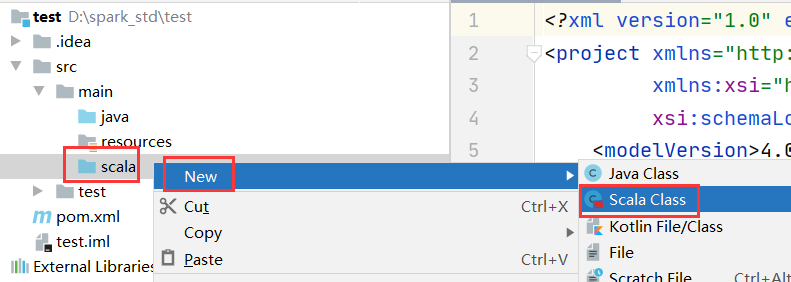
代码
查询 ele_num > 100 的记录
import org.apache.spark.SparkConf
import org.apache.spark.sql.{DataFrame, SparkSession}

object Std1_sparksql {
  def main(args: Array[String]): Unit = {
    val sc = new SparkConf().setMaster("local[*]").setAppName("std")
    //创建SparkSession
    val ss: SparkSession = SparkSession.builder().config(sc).getOrCreate()


    val df: DataFrame = ss.read
      .option("header", "false") //默认为false,表示第一行不是表头
      .option("sep", ",") //列分隔符
      .csv("cdz.txt") //读取本地文件
      .toDF("id","ele_num","time","start_time","end_time") //设置列名,默认列名不方便查询
      //.withColumnRenamed("_c0", "id") //给列起别名
      //.withColumnRenamed("_c1", "ele_num")
      //.withColumnRenamed("_c2", "time")
      //.withColumnRenamed("_c3", "start_time")
      //.withColumnRenamed("_c4", "end_time")

    df.printSchema() // 打印 字段类型Schema
    //显示所有数据
//    df.show()
    //创建局部临时视图(只在当前session中可用,视图:只能查询不能修改)
    df.createOrReplaceTempView("cdz")
    val resDF: DataFrame = ss.sql("select id,ele_num,time,start_time,end_time from cdz where ele_num > 100 ")
    resDF.show()
    ss.stop() //关闭
  }
}
解释:
- 也可以读取 HDFS 文件:
csv("hdfs://hadoop1:8020/data/cdz.txt")
执行结果
Schema:
root
 |-- id: string (nullable = true)
 |-- ele_num: string (nullable = true)
 |-- time: string (nullable = true)
 |-- start_time: string (nullable = true)
 |-- end_time: string (nullable = true)
+—-+———-+——+—————————-+—————————-+
| id|ele_num|time| start_time| end_time|
+—-+———-+——+—————————-+—————————-+
| 2| 200| 25|2020-01-11 10:40:50|2020-01-11 11:05:50|
| 3| 150| 12|2020-01-01 11:20:50|2020-01-01 11:32:50|
| 1| 300| 50|2020-01-03 14:30:50|2020-01-03 15:20:10|
| 2| 500| 50|2020-02-02 15:30:30|2020-02-02 17:20:30|
| 3| 150| 12|2020-02-01 11:20:50|2020-02-01 11:32:50|
| 3| 150| 12|2020-02-03 11:20:50|2020-02-03 11:32:50|
| 2| 500| 120|2020-03-12 15:30:30|2020-03-12 17:30:30|
| 2| 500| 120|2020-03-22 15:30:30|2020-03-22 17:30:30|
| 3| 400| 50|2020-03-02 17:30:20|2020-03-02 18:20:20|
| 5| 150| 12|2020-04-11 11:20:50|2020-04-11 11:32:50|
| 6| 150| 20|2020-04-15 11:20:50|2020-04-15 11:40:50|
+—-+———-+——+—————————-+—————————-+
统计例子
统计各个充电桩的 ele_num 和
import org.apache.spark.SparkConf
import org.apache.spark.sql.{DataFrame, SparkSession}

object Std1_sparksql {
  def main(args: Array[String]): Unit = {
    val sc = new SparkConf().setMaster("local[*]").setAppName("std")
    //创建SparkSession
    val ss: SparkSession = SparkSession.builder().config(sc).getOrCreate()


    val df: DataFrame = ss.read
      .option("header", "false") //默认为false,表示第一行不是表头
      .option("sep", ",") //列分隔符
      .csv("cdz.txt") //读取本地文件
      .toDF("id","ele_num","time","start_time","end_time") //设置列名,默认列名不方便查询
    //创建临时视图(只在当前session中可用,视图:只能查询不能修改)
    df.createOrReplaceTempView("cdz")
    println("统计各充电桩的充电量")
    val frame: DataFrame = ss.sql("select id,sum(ele_num) as `充电量` from cdz group by id")
    //不合并分区,会产生200个文件
    frame.rdd.coalesce(1).saveAsTextFile("res2")
    ss.stop() //关闭
  }
}
生成文件
合并成一个分区,并保存文件,内容如下:
[3,850.0]
[5,150.0]
[6,150.0]
[1,650.0]
[4,150.0]
[2,1700.0]
总结
编写流程:
- 连接数据源
- 创建表、视图
- 执行SQL
- 打印、保存结果