问题
如果 Driver 有 外部变量:大数组 BigArr ,数据量很大,需要占用 1G 内存。在运行的时候需要在 Executor 进程里面运行,那么就需要将这个 BigArr 分发过去
如果每个 Executor 有两个线程,那么每个线程就有一个 BigArr,那么一个Executor进程就会有 2个G 的BigArr
如下图:
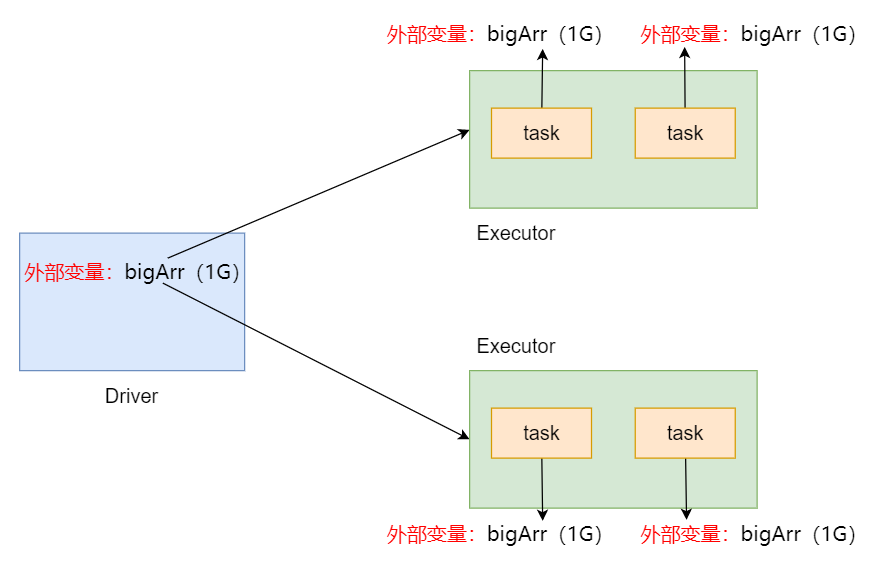
如果程序 只是对 BigArr 进行读操作,而不进行修改操作,一个 Executor 可以用 一个BigArr
否则:占用内存太大了,而且是没有必要的
例子
- 定义一个rdd
- 定义一个
1-1000的数组,表示很大的数据 - 过滤出 重复 的 元素
实现代码如下:
import org.apache.spark.rdd.RDD
import org.apache.spark.{SparkConf, SparkContext}


val conf = new SparkConf().setMaster("local[*]").setAppName("Application")
//构建Spark上下文对象
val sc = new SparkContext(conf)
val rdd: RDD[Int] = sc.makeRDD(List(30, 50000000, 70, 600000, 10, 20))


val bigArr = 1 to 1000 toArray

val rdd2 = rdd.filter(x => bigArr.contains(x))
rdd2.collect.foreach(println)
sc.stop()
缺点:每个 task 都会有这个很大的数组,占用内存太大
解决:广播变量
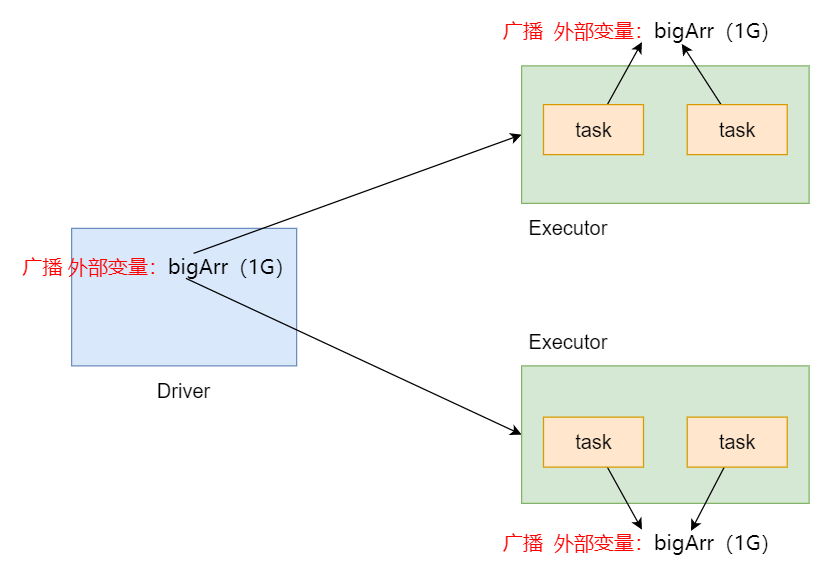
分布式共享 只读变量
广播变量在每个节点上保存一个只读的变量, 而不用给每个 task 来传送一个 copy
使用
广播变量通过调用 SparkContext.broadcast(v) 来创建
通过调用广播变量的 value 方法可以访问值
代码
将 很大的数组 广播出去,一个 Executor 可以用 一个数组
val conf = new SparkConf().setMaster("local[*]").setAppName("Application")
//构建Spark上下文对象
val sc = new SparkContext(conf)
val rdd: RDD[Int] = sc.makeRDD(List(30, 50000000, 70, 600000, 10, 20))

//演示很大的数据
val bigArr = 1 to 1000 toArray
// 广播出去
val bd: Broadcast[Array[Int]] = sc.broadcast(bigArr)

// 过滤rdd和bigArr有交集的变量
val rdd2 = rdd.filter(x => bd.value.contains(x))
rdd2.collect.foreach(println)
sc.stop()
感谢:https://blog.csdn.net/qq_41489540/article/details/110003639