介绍
spark 提供 pyspark 命令,该命令提供 交互的方式 执行代码,一般用于测试、调试、演示
命令位置
/program/spark-3.0.0/bin
启动命令
pyspark --master local[*]
解释:
--master:后面可以是以下参数:local:本地运行,只有一个工作进程local[n]:本地运行,只有 n 个工作进程,通常 n 为核心数量local[*]:默认值。本地运行,工作进程数量为核心数量yarn:表示driver进程在yarn集群上(多用于生成环境)。需要 yarn方式部署spark
启动后,访问 http://hadoop1:4040 ,显示 web监控页面,如下:
例子-本地方式
执行下面命令:
pyspark
或者
pyspark --master local[2]
提示:本地运行,只有 2 个工作进程
显示界面如下:

web 页面
访问 http://hadoop1:4040 ,显示 web监控页面,如下:

例子-YARN方式
注意:需要 yarn方式部署spark
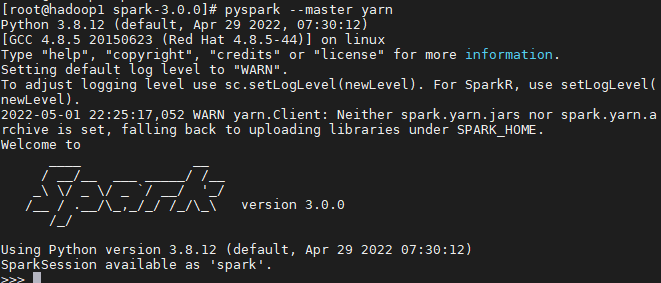
pyspark --master yarn
执行结果如下:
web 页面
访问 http://hadoop1:4040 ,显示 web监控页面,如下:
统计词频
准备文件
vim data.txt
李雷  lucy
韩梅梅 李雷
lucy  韩梅梅
lili 李雷
张三  lucy
李四  韩梅梅
王五  韩梅梅
李雷  lucy
韩梅梅
lucy 李雷
李雷 李雷
韩梅梅  lucy
李雷 韩梅梅
上传到 HDFS 的 /data 目录下
统计词频-方式一
把下面代码复制到 pyspark 环境中:
textFile = sc.textFile("/data/data2.txt")
rdd = textFile.flatMap(lambda line:line.split(" "))
rdd2 = rdd.map(lambda e:(e,1))
rdd3 = rdd2.reduceByKey(lambda a, b: a + b)
rdd3.foreach(print)
执行结果:
('李雷', 8)
('', 7)
('lucy', 6)
('韩梅梅', 7)
('lili', 1)
('张三', 1)
('李四', 1)
('王五', 1)
统计词频-方式二
把下面代码复制到 pyspark 环境中:
textFile = sc.textFile("/data/data2.txt")
rdd = textFile.flatMap(lambda line:line.split(" "))
rdd2 = rdd.groupBy(lambda e:e)
rdd3 = rdd2.map(lambda e:e[0]+","+str(len(e[1])))
rdd3.foreach(print)
执行结果:
李雷,8
,7
lucy,6
韩梅梅,7
lili,1
张三,1
李四,1
王五,1
web 页面
访问 http://hadoop1:4040 ,显示 web监控页面,如下:
可以看到上面运行的任务
退出
执行下面命令退出:
exit()
退出后,web服务也关闭了