行式存储
传统的 关系型数据库 采用 行式存储(Row-based),适合做业务数据库,如 Oracle、MySQL、SQL SERVER 等
一行中的数据在存储介质中以连续存储形式存在
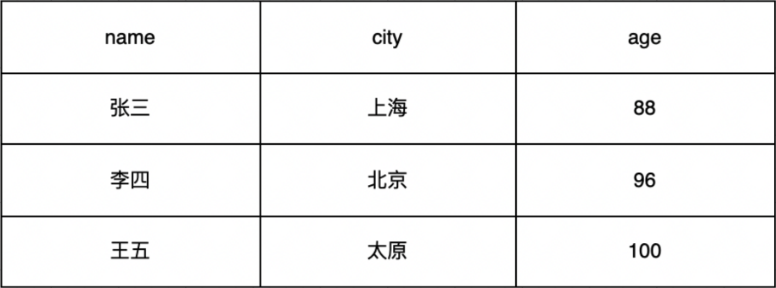
关系型数据库中,看到的表数据如下图:
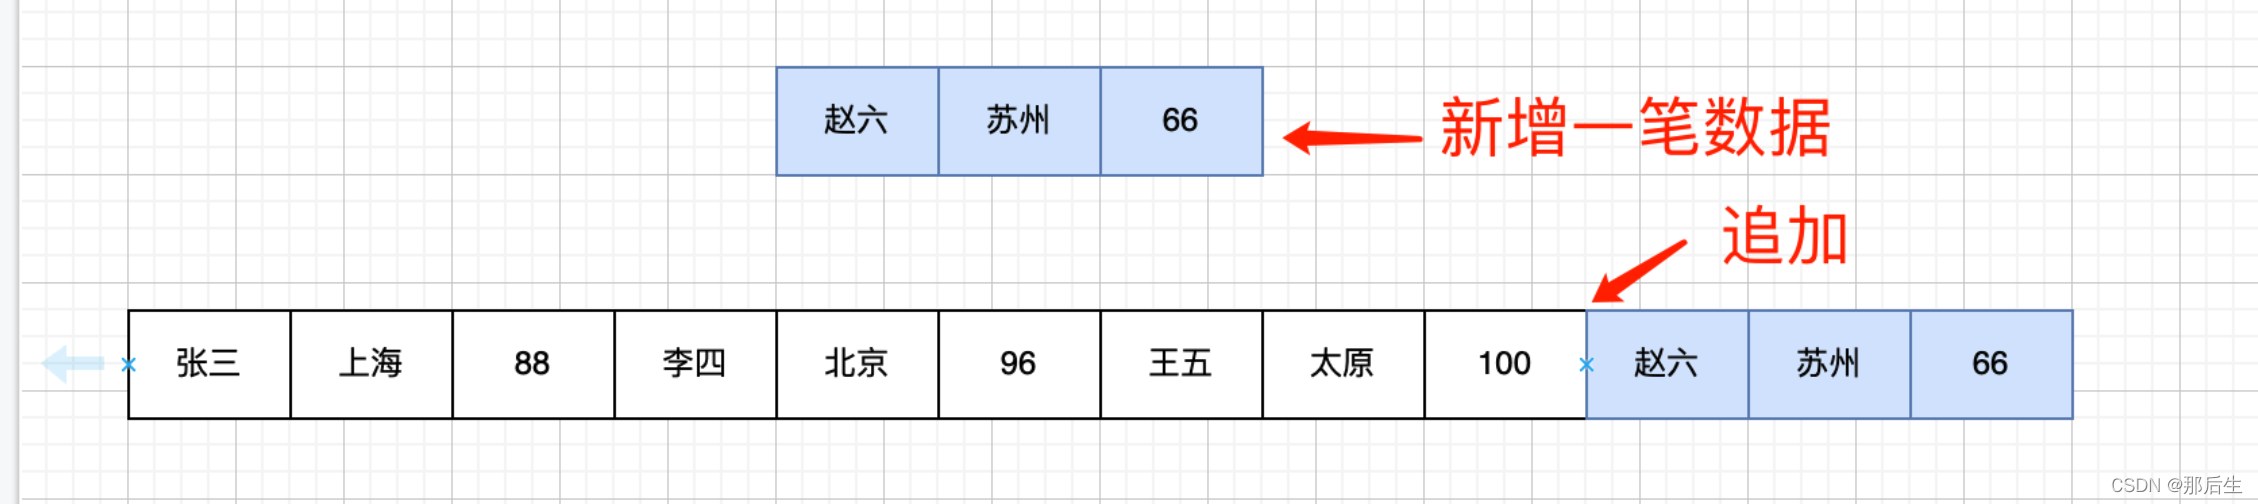
按照行的顺序,将这三行数据存储在硬盘上,如下图:

优点
写入数据非常的快。只需要将新增的数据在后面追加,存储在磁盘上最终是连续的空间
读取整行数据快
缺点
查询少数几列时,由于这几列混在其他列中,需要读取每一条完整的记录,导致速度慢
聚合速度慢,如:
select avg(age)等,原因同上
应用场景
适合 OATP 数据库,做业务处理,如:MySQL、oracle
列式存储
列式数据库,适合 大数据 环境下的 数据仓库,用于 数据分析 ,如:Hbase、hive的 Parquet、RCFile、ORCFile 文件格式
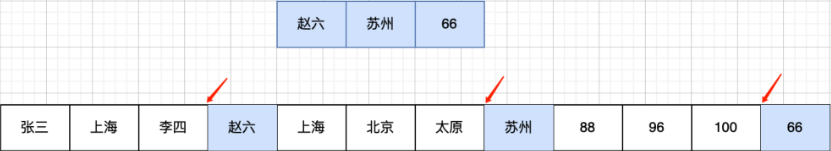
一列中的数据在存储介质中以连续存储形式存在
存储结构如下图:

新增一条数据如下
优点
聚合速度快。如:
select avg(age),只需要将磁盘上连续的 年龄 加载到内存中,不需要读取其他列数据压缩比更好。由于某一列的数据类型都是相同的,针对于数据存储更容易进行数据压缩,每一列选择更优的数据压缩算法,大大提高了数据的压缩比重。数据压缩比更好,一方面节省了磁盘空间,另一方面对于cache也有了更大的发挥空间
应用场景
适合 OLAP,做统计分析,如:clickhouse、hive
对比
| 对比方面 | 行存储 | 列存储 |
|---|---|---|
| 写性能 | 写人是一次完成,性能更高 | 把一行记录拆分成单列保存,写入次数明显比行存储多,实际花费时间比行存储多 |
| 读性能 | 读取少数几列时,需遍历其他无关列,IO开销较大;读取整行数据时,依次顺序读即可,性能高 | 读取少数几列时,无需读取无关列,性能高;读取整行时,需分别读取所有列,并拼装成行,性能低 |
| 数据压缩 | 每行数据存储在一起,压缩比较低 | 以列为单位存储数据,这使得类型相同的数据存放在一起,对压缩算法友好,压缩比较高 |
| 典型代表 | Text File、 Sequence File等 | ORC、 Parquet、 Carbon Data等 |
感谢:
https://blog.csdn.net/wangrui1605/article/details/122023482
https://blog.csdn.net/Shockang/article/details/115739955