说明
union 算子可以合并 多个 同类型的数据流,并生成一个同类型的数据流。
数据将按照先进先出(First In First Out)的模式合并,且不去重。
下图 union 对白色和深色两个数据流进行合并,生成一个数据流:

方法声明
public final DataStream<T> union(DataStream<T>... streams)
形参解释: 可连接多个数据流
应用场景
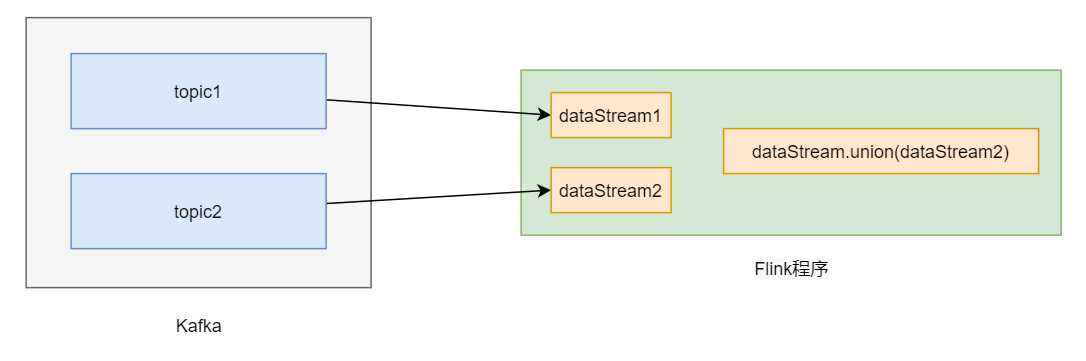
短视频app收集用户行为,将 点赞(like),播放次数(play),评论(comment),分享(share),举报(negative) 等数据,发送到不同的 kafka 主题中。
如果需要统计 每一个视频的 点赞,播放次数,评论,分享,举报 等实时指标,就需要 合并这些流,然后进行统计处理
案例
简化上面的应用场景,kafka启动两个生产者,一个是 play,一个是 like,flink程序连接这两个主题,并合并,打印数据
java
package top.malaoshi;

import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.connectors.kafka.FlinkKafkaConsumer;
import org.apache.kafka.clients.consumer.ConsumerConfig;

import java.util.Properties;

public class F1union {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        // 定义kafka相关配置项
        Properties pro = new Properties();
        pro.setProperty(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "hadoop1:9092,hadoop2:9092,hadoop3:9092");
        pro.setProperty(ConsumerConfig.GROUP_ID_CONFIG, "consumer-group");
        pro.setProperty(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG, "latest");

        // 连接kafka play主题
        FlinkKafkaConsumer<String> playFKC = new FlinkKafkaConsumer<>("play", new SimpleStringSchema(), pro);
        DataStreamSource<String> playDSS = env.addSource(playFKC);

        // 连接kafka like主题
        FlinkKafkaConsumer<String> likeFKC = new FlinkKafkaConsumer<>("like", new SimpleStringSchema(), pro);
        DataStreamSource<String> likeDSS = env.addSource(likeFKC);

        // 将两个主题合并
        DataStream<String> unionDS = playDSS.union(likeDSS);

        unionDS.print();

        env.execute();
    }

}
启动zk
登录 hadoop1,执行下面命令:
/program/bin/zk.sh start
启动kafka
登录 hadoop1,执行下面命令:
/program/bin/kafka.sh start
启动 flink
在 idea 中运行 flink 程序
创建生产者、指定主题 play
/program/kafka_2.12-2.4.1/bin/kafka-console-producer.sh --broker-list hadoop1:9092,hadoop2:9092,hadoop3:9092 --topic play
然后输入:
{"name":"李雷","vid":"1","time":"2020-09-01 10:00:00","type":"play"}
{"name":"lili","vid":"2","time":"2020-09-01 10:00:00","type":"play"}
提示: vid 是视频id
创建生产者、指定主题 like
/program/kafka_2.12-2.4.1/bin/kafka-console-producer.sh --broker-list hadoop1:9092,hadoop2:9092,hadoop3:9092 --topic like
然后输入:
{"name":"李雷","vid":"1","time":"2020-09-01 10:00:00","type":"like"}
{"name":"lili","vid":"3","time":"2020-09-01 10:00:00","type":"like"}
执行结果
在 idea 控制台中打印结果如下:
2> {"name":"����","vid":"1","time":"2020-09-01 10:00:00","type":"play"}
5> {"name":"lili","vid":"2","time":"2020-09-01 10:00:00","type":"play"}
2> {"name":"����","vid":"1","time":"2020-09-01 10:00:00","type":"like"}
2> {"name":"lili","vid":"3","time":"2020-09-01 10:00:00","type":"like"}
两个kafka主题中的数据,都能接收到
参考
https://cloud.tencent.com/developer/article/1560680
https://cloud.tencent.com/developer/article/1864646