说明
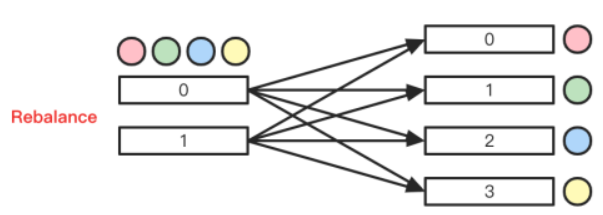
rebalance()按照 round-robin (轮询)的方式,上游数据轮询下发到下游算子
提示: 在 kafka 环境下,需要创建多个分区
方法声明
在 filter、map 等方法后都可以调用
public DataStream<T> rebalance()
在 slot中进行操作
如下图:

应用场景
- 上下游算子并发度不一致
- 存在数据倾斜
与broadcast()算子的区别

上图颜色点代表两者数据分发的区别
默认是 rebalance
当上下游算子 并行度 不一样时,默认的数据传递方式是rebalance
验证
使用 webui 的方式创建 运行环境,执行下面的 flink程序
任务计划
数据源的并行度是 1,map 算子的并行度是 2,上下游算子 并行度 不一样,所以是 rebalance

代码
import org.apache.flink.api.common.functions.RichMapFunction;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;


public class Reblance {

    public static void main(String[] args) throws Exception {
        final StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        // 设置整个环境的并行度是2
        env.setParallelism(2);

        // 该数据源的并行度是 1
        DataStreamSource<String> ds = env.fromElements("lilei", "lili", "lucy", "hanmeimei");
        ds
                .map(new MapFunImpl()) // map算子受整个环境的控制,所以并行度是2
                .print();

        System.out.println(env.getExecutionPlan());
        env.execute("myjob");
    }

    static class MapFunImpl extends RichMapFunction<String, Tuple2<String,Integer>> {

        @Override
        public Tuple2<String, Integer> map(String value) throws Exception {
            int index = getRuntimeContext().getIndexOfThisSubtask();
            // 重新组装数据, (原始数据,分区索引)
            return Tuple2.of(value,index);
        }
    }
}
执行结果:
1> (lili,0)
2> (lilei,1)
1> (hanmeimei,0)
2> (lucy,1)
说明说下图:

kafka 例子
package top.malaoshi;

import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.configuration.Configuration;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.connectors.kafka.FlinkKafkaConsumer;
import org.apache.kafka.clients.consumer.ConsumerConfig;

import java.util.Properties;

public class F9rebalance_kafka {
    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.createLocalEnvironmentWithWebUI(new Configuration());
        // 定义kafka相关配置项
        Properties pro = new Properties();
        pro.setProperty(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop1:9092,hadoop2:9092,hadoop3:9092");
        pro.setProperty(ConsumerConfig.GROUP_ID_CONFIG,"consumer-group");
        pro.setProperty(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG,"latest");

        // 创建FlinkKafka消费者,需要指定主题、反序列化、kafka配置
        FlinkKafkaConsumer<String> fkc = new FlinkKafkaConsumer<>("kafka2flink", new SimpleStringSchema(), pro);

        DataStreamSource<String> dss = env.addSource(fkc);

        SingleOutputStreamOperator<Integer> mapSOSO = dss.map(item -> Integer.parseInt(item))
                .setParallelism(2);
        SingleOutputStreamOperator<Integer> filterSOSO = mapSOSO.filter(item -> item < 10)
                .setParallelism(4);

        env.execute();
    }
}
参考
https://blog.51cto.com/u_9928699/5670559