案例
为了便于演示,每 10 秒统计一次,统计 最近 10 秒内 的 最高温度。最多延迟5秒
flink java代码
package watermarker;

import org.apache.flink.api.common.eventtime.SerializableTimestampAssigner;
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.functions.MapFunction;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.api.java.functions.KeySelector;
import org.apache.flink.api.java.tuple.Tuple3;
import org.apache.flink.shaded.jackson2.com.fasterxml.jackson.databind.JsonNode;
import org.apache.flink.shaded.jackson2.com.fasterxml.jackson.databind.ObjectMapper;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.KeyedStream;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;
import org.apache.flink.streaming.connectors.kafka.FlinkKafkaConsumer;
import org.apache.kafka.clients.consumer.ConsumerConfig;

import java.text.SimpleDateFormat;
import java.time.Duration;
import java.util.Date;
import java.util.Properties;

public class SlidingWindow简单验证 {

    static long maxOutOfOrderness = 5;

    public static void main(String[] args) throws Exception {

        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        // 定义kafka相关配置项
        Properties pro = new Properties();
        pro.setProperty(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop1:9092,hadoop2:9092,hadoop3:9092");
        pro.setProperty(ConsumerConfig.GROUP_ID_CONFIG,"consumer-group");
        pro.setProperty(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG,"latest");
        // 内置连接器,创建FlinkKafka消费者,需要指定主题、反序列化、kafka配置
        FlinkKafkaConsumer<String> fkc = new FlinkKafkaConsumer("kafka2flink", new SimpleStringSchema(), pro);
        DataStreamSource<String> dss = env.addSource(fkc);

        // map解析json数据
        SingleOutputStreamOperator<Tuple3<String, Double, Long>> mapSOSO = dss.map(new MyMap());

        // 设置watermark最大迟到时间
        WatermarkStrategy<Tuple3<String, Double, Long>> maxDelayWS = WatermarkStrategy
                .<Tuple3<String, Double, Long>>forBoundedOutOfOrderness(Duration.ofSeconds(maxOutOfOrderness));

        //指定watermark事件时间字段
        WatermarkStrategy<Tuple3<String, Double, Long>> timestampWS = maxDelayWS
                .withTimestampAssigner(new MySerializableTimestampAssigner());

        // 设置 watermark
        SingleOutputStreamOperator<Tuple3<String, Double, Long>> watermarkSOSO = mapSOSO
                .assignTimestampsAndWatermarks(timestampWS);

        // keyBy分组
        KeyedStream<Tuple3<String, Double, Long>, String> keyByKS = watermarkSOSO
                .keyBy(new KeySelector<Tuple3<String, Double, Long>, String>() {

                    @Override
                    public String getKey(Tuple3<String, Double, Long> value) throws Exception {
                        return value.f0;
                    }
                });
        // 设置滚动窗口、并求最大值
        SingleOutputStreamOperator<Tuple3<String, Double, Long>> maxSOSO = keyByKS
                .window(TumblingEventTimeWindows.of(Time.seconds(10)))
                .max(1);// 根据索引是1的字段,取出最大值

        maxSOSO.print("result:");

        env.execute();
    }

    public static class MySerializableTimestampAssigner implements SerializableTimestampAssigner<Tuple3<String, Double, Long>>{
        private long watermarker = 0;
        private long eventTime = 0;
        @Override
        public long extractTimestamp(Tuple3<String, Double, Long> element, long recordTimestamp) {
            // 取出最大事件。注意:这种方式实现,并不准确
            eventTime = Math.max(element.f2,eventTime);
            // 计算watermark。注意:这种方式实现,并不准确
            watermarker = eventTime - maxOutOfOrderness*1000;

            Date date = new Date(recordTimestamp);
            Date dateData = new Date(element.f2);
            Date dateWatermarker = new Date(watermarker);

            SimpleDateFormat sdf = new SimpleDateFormat("HH:mm:ss");

            String format = sdf.format(date);
            String formatData = sdf.format(dateData);
            String formatWatermarker = sdf.format(dateWatermarker);

            // 打印最大温度、事件时间、系统时间、watermark
            System.out.println("receive--temp:"+element.f1+ ", recordTimestamp:"+formatData+", system time:"+format+",watermarker:"+formatWatermarker);
            return element.f2;
        }
    }

    public static class MyMap implements MapFunction<String, Tuple3<String,Double,Long>>{
        @Override
        public Tuple3<String,Double,Long> map(String data) throws Exception {
            ObjectMapper om = new ObjectMapper();
            JsonNode jsonNode = om.readTree(data);
            JsonNode idJN = jsonNode.get("id");
            JsonNode tempJN = jsonNode.get("temp");
            JsonNode timeJN = jsonNode.get("time");

            String id = null;
            Double temp = null;
            long timeStamp = 0;

            if(idJN!=null){
                id = idJN.asText();
            }
            if(tempJN!=null){
                temp = tempJN.asDouble();
            }
            String timeStr = null;
            if(timeJN!=null){
                timeStr = timeJN.asText();
                SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss");
                Date date = sdf.parse(timeStr);
                timeStamp = date.getTime();
            }
            return Tuple3.of(id,temp,timeStamp);
        }
    }
}
kafka 生产者
其他配置见 flink1.12.x WaterMarker 案例:kafka生产者
主类
package top.malaoshi.kafka;

import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;

import java.util.Properties;

public class Producer循环发送 {

    final static String TOPIC = "kafka2flink";

    public static void main(String[] args) throws InterruptedException {
        // 1. 创建 kafka 生产者的配置对象
        Properties properties = new Properties();
        // 2. 给 kafka 配置对象添加配置信息:bootstrap.servers
        properties.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG,"hadoop1:9092,hadoop2:9092,hadoop3:9092");
        // key,value 序列化(必须):key.serializer,value.serializer
        properties.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer");
        // StringSerializer.class.getName() 等于 org.apache.kafka.common.serialization.StringSerializer
        properties.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG,
                "org.apache.kafka.common.serialization.StringSerializer") ;

        // 3. 创建 kafka 生产者对象
        KafkaProducer<String, String> kafkaProducer = new KafkaProducer(properties);

        double temp = 1;
        for(int i=0;i<50;i++) {
            // 4. 调用 send 方法,发送消息,全部延迟2秒
            String event1 = EventBuilder.buildJson("1", temp+i, 2);
            kafkaProducer.send(new ProducerRecord(TOPIC , event1));
            System.out.println("send:" + event1);
            Thread.sleep(1000);
        }

        // 5. 关闭资源
        kafkaProducer.close();
        System.out.println("end...");
    }
}
测试
启动zk
登录 hadoop1,执行下面命令:
/program/bin/zk.sh start
启动kafka
登录 hadoop1,执行下面命令:
/program/bin/kafka.sh start
启动 flink
在 idea 中运行 flink 程序
启动生产者、指定主题
执行上面的 kafka 生产者
执行结果
在 idea 控制台中打印结果如下:
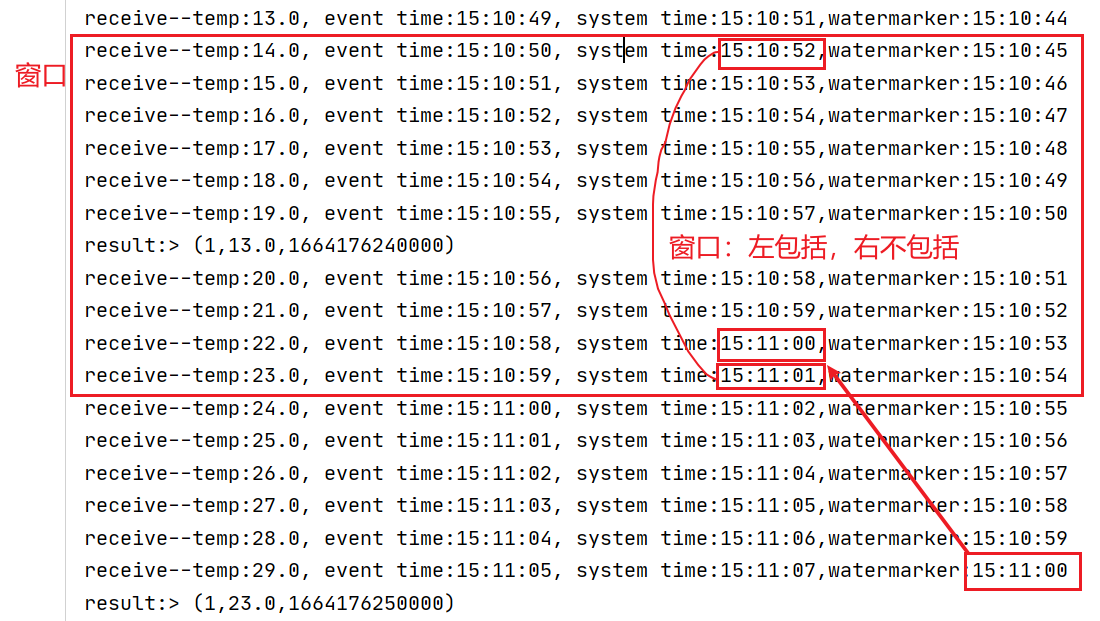
注意: 由于是 自行模拟实现的,所以有误差,watermark 没有比 上一个窗口的结束时间大,就触发计算了。但通过观察,此规律稳定,仍然可以作为依据