案例
为了演示 savepoint,需要将 flink 程序打包,发送到 flink 服务中运行
这里为了方便演示效果,只用 socket(没用kafka):从 socket 服务端接收数据,取出最大值后,发送到 socket 客户端中

flink程序
java
package savepoint;

import org.apache.flink.api.common.functions.FlatMapFunction;
import org.apache.flink.api.common.functions.MapFunction;
import org.apache.flink.api.common.serialization.SimpleStringSchema;
import org.apache.flink.api.java.functions.KeySelector;
import org.apache.flink.api.java.tuple.Tuple2;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.sink.SocketClientSink;
import org.apache.flink.util.Collector;
import org.slf4j.Logger;
import org.slf4j.LoggerFactory;

public class S1socket {
    final static Logger log = LoggerFactory.getLogger(S1socket.class);

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        DataStreamSource<String> dss = env.socketTextStream("hadoop1", 9999);

        SingleOutputStreamOperator<Tuple2<String,Double>> soso = dss
                .flatMap(new FlatMapFunction<String,Tuple2<String,Double>>(){

                    @Override
                    public void flatMap(String s, Collector<Tuple2<String, Double>> out) throws Exception {

                        String[] arr = s.split(",");
                        if(arr.length == 2){
                            double temp = Double.parseDouble(arr[1]);
                            out.collect(Tuple2.of(arr[0],temp));
                        }else{
                            log.error("数据格式不正确,数据:"+s);
                        }
                    }
                })

                .keyBy(new KeySelector<Tuple2<String,Double>,String>(){

                    @Override
                    public String getKey(Tuple2<String, Double> value) throws Exception {
                        return value.f0;
                    }
                })
                .maxBy(1);

        SingleOutputStreamOperator<String> result = soso.map(new MapFunction<Tuple2<String, Double>, String>() {
            @Override
            public String map(Tuple2<String, Double> value) throws Exception {
                return value.f0 + "," + value.f1+"\n";
            }
        });

        result.print("result::");

        SocketClientSink scs = new SocketClientSink("hadoop1",8888,new SimpleStringSchema());
        result.addSink(scs);
        env.execute();
    }


}
打包
执行 maven 的 package
上传 flink 包
将 jar 包上传到 hadoop1 的 /program 目录下
启动 hadoop
/program/bin/hadoop.sh start
启动 socket
启动服务器
nc -lk 9999
启动客户端
nc -lk 8888
启动 flink 集群
cd /program/flink-1.12.5
bin/yarn-session.sh
或者
bin/yarn-session.sh -n 2 -tm 800 -s 1 -d
flink web ui
下图红框处,是 flink web ui 网址

看到下图,说明启动成功:

提交任务
bin/flink run --class savepoint.S1socket /program/kafka2flink-1.0-SNAPSHOT.jar
flink web ui
看到下图,说明提交成功

测试
输入测试数据
在 nc -lk 9999 服务器上,输入下面数据:
1,20
1,21
1,10
1,22
查看输出结果
在 nc -lk 8888 服务器上,看到下面结果:
1,20.0
1,21.0
1,21.0
1,22.0
手动触发 savepoint
命令格式
bin/flink savepoint flink任务id hdfs路径
查看 flink任务id - 命令窗口
提交任务的窗口,如下图:
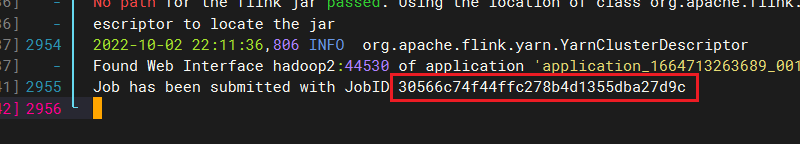
查看 flink任务id - flink web

执行命令
bin/flink savepoint 30566c74f44ffc278b4d1355dba27d9c hdfs://hadoop1:8020/flink_savepoint
执行结果
看到下图,说明执行成功,并且给出保存路径:

查看 hdfs 文件
看到下图,说明创建成功:

停止任务 - 命令方式
格式
bin/flink cancel flink任务id
执行命令
bin/flink cancel 30566c74f44ffc278b4d1355dba27d9c
停止任务 - flink web方式

启动任务并恢复
格式
bin/flink run -s savepoint路径 --class 类路径 jar包路径
查看 savepoint 路径
执行命令
bin/flink run -s hdfs://hadoop1:8020/flink_savepoint/savepoint-30566c-4a4291a5602e --class savepoint.S1socket /program/kafka2flink-1.0-SNAPSHOT.jar
测试状态是否恢复
输入测试数据
在 nc -lk 9999 服务器上,输入下面数据:
1,10
查看输出结果
在 nc -lk 8888 服务器上,看到下面结果:
1,22.0
说明 这个 1,22.0 已经从 savepoint 恢复了