说明
在流式处理中,有时也需要在 两条流 做 join 操作,将两个流中的数据,根据 key 组合成新数据
window join 相当于 SQL 中的 inner join,如:
select t.id,t.name,s.id,s.name from teaher t inner join student s on t.id = s.teacher_id
官网
https://nightlies.apache.org/flink/flink-docs-release-1.13/zh/docs/dev/datastream/operators/joining/
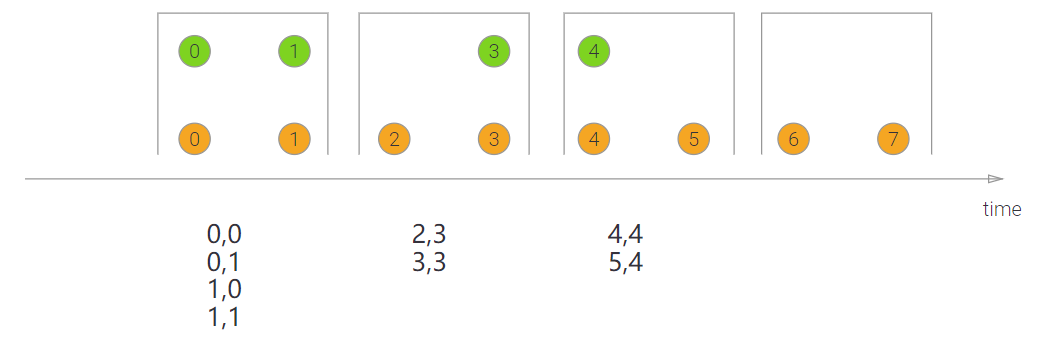
代码
DataStream<Integer> orangeStream = ...
DataStream<Integer> greenStream = ...

orangeStream.join(greenStream)
    .where(<KeySelector>)
    .equalTo(<KeySelector>)
    .window(TumblingEventTimeWindows.of(Time.milliseconds(2)))
    .apply (new JoinFunction<Integer, Integer, String> (){
        @Override
        public String join(Integer first, Integer second) {
            return first + "," + second;
        }
    });
处理流程

两条流的数据,进入对应的窗口,缓存在内部State状态中
当到达窗口结束时间时,算子 根据
key,对两条流中的数据做一个 笛卡尔积然后进行遍历,把每一对匹配的数据,作为参数 传入
apply()方法进行计算处理
一句话理解
利用 window 机制,将 2个流中的元素分配到窗口中,并在窗口完成时,进行 join 操作,根据 key 将 数据联结起来
没有匹配的数据如何处理?
SQL
由于 窗口 join,类似 SQL join,如下:
select t.id,t.name,s.id,s.name from teaher t inner join student s on t.id = s.teacher_id
在 SQL 中,查询出来的数据,一定在两个表中 t.id 和 s.teacher_id 都对应匹配,只要 对应匹配不上,就查询不到
window join
同理 SQL,如上图,窗口2 中,数据 "b",7, 6000 ,就没有 对应匹配 的数据,直接丢弃,不会执行
应用场景
传感器监控火情,需要将大量 温度传感器 和 烟雾传感器 采集到的信息,分别发送到 各自的 kafka 主题中
flink接收到数据后,将两条流中数据合并起来,按照传感器 group_id 分组(同属一个地理位置,即:key),如果同时 超过设定阈值就 发出警报
api
调用方式如下:
input1.join(input2)
  .where(...)       // 为input1指定键值属性
  .equalTo(...)     // 为input2指定键值属性
  .window(...)      // 指定WindowAssigner
  [.trigger(...)]   // 选择性的指定Trigger
  [.evictor(...)]   // 选择性的指定Evictor
  .apply(...)       // 处理匹配的数据
解释:
input1.join(input2):相当于上面 SQL 中的from teaher t inner join student s.where(...) . equalTo(...):相当于上面 SQL 中的on t.id = s.teacher_id.where(...):参数是键选择器(KeySelector),用来指定第一条流中的key.equalTo(...):参数是键选择器(KeySelector),指定了第二条流中的key如果在同一窗口中,就可以匹配起来,并通过一个“联结函数”(JoinFunction)进行处理
.window():传入窗口分配器,三种时间窗口都可以用在这里:滚动窗口(tumbling window)
滑动窗口(sliding window)
会话窗口(session window)
.apply(...):处理匹配数据。有两种重载方法:传入
JoinFunction:使用时需要实现内部的.join()方法。这个方法有两个参数:分别表示两条流中成对匹配的 数据传入
FlatJoinFunction:使用时需要实现内部的.join()方法。这个方法有两个参数:分别表示两条流中成对匹配的 数据窗口中每有一对数据成功联结匹配,上面方法就会被调用一次
JoinFunction 源码
public interface JoinFunction<IN1, IN2, OUT> extends Function, Serializable {
    // 第一个形参是流 1 的元素
    // 第二个形参是流 2 的元素
    // 并返回 新元素
    OUT join(IN1 first, IN2 second) throws Exception;
}
FlatJoinFunction 源码
public interface FlatJoinFunction<IN1, IN2, OUT> extends Function, Serializable {
    // 第一个形参是流 1 的元素
    // 第二个形参是流 2 的元素
    // 第三个形参,返回一个元素 或 多个元素
    void join (IN1 first, IN2 second, Collector<OUT> out) throws Exception;
}
设置 watermark
因为是基于 window 的,还要设置 watermark
案例
订单案例,kafka启动两个生产者,一个是 order,一个是 goods,flink程序连接这两个主题,并执行 join()
传感器监控火情,温度传感器、烟雾传感器 采集到的信息,分别发送到两个流中,按照传感器 group_id 分组(同属一个地理位置),再将两条流中数据合并起来,如果同时超过设定阈值(如:温度大于等于 100℃,并且 烟雾浓度 大于等于 7)就要报警
温度传感器 数据格式:
Tuple3.of("a",36.1, 1000)
解释
- 第一个元素:group id
- 第二个元素:温度,
Double类型 - 第三个元素:事件时间
烟雾传感器 数据格式:
Tuple3.of("a",1, 1000)
解释
- 第一个元素:group id
- 第二个元素:烟雾浓度,
Integer类型 - 第三个元素:事件时间
join后的 数据格式:
"a",36.1, 1000 === "a",1, 1000
解释:将第一个元素 和 第二个元素 拼成字符串
java 代码(演示)
这里为了演示,没有使用 kafka,直接生成模拟数据,只是将 join 后数据 拼成字符串,并打印
package join;

import org.apache.flink.api.common.eventtime.SerializableTimestampAssigner;
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.functions.JoinFunction;
import org.apache.flink.api.java.tuple.Tuple3;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;

import java.time.Duration;

public class C1Tumbling {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        // 温度传感器数据
        DataStreamSource<Tuple3<String, Double,Integer>> dss1 = env.fromElements(
                Tuple3.of("a",36.1, 1000), // 第一个元素表示传感器id,第二个元素表示温度,第三个元素表示时间戳
                Tuple3.of("b",32.2, 1000),
                Tuple3.of("a",26.3, 2000),
                Tuple3.of("b",29.4, 2000)
        );
        // 烟雾传感器数据
        DataStreamSource<Tuple3<String, Integer,Integer>> dss2 = env.fromElements(
                Tuple3.of("a",1, 3000), // 第一个元素表示传感器id,第二个元素表示烟雾浓度,第三个元素表示时间戳
                Tuple3.of("b",6, 3000),
                Tuple3.of("a",1, 4000),
                Tuple3.of("b",7, 6000)
        );

        // 定义 流1 的水位线
        WatermarkStrategy<Tuple3<String, Double, Integer>> wsOfDss1 = WatermarkStrategy
                /*
                 设置watermark最大迟到时间
                 这里为了简单设置为0
                 必须设置泛型,否则报错
                 */
                .<Tuple3<String, Double,Integer>>forBoundedOutOfOrderness(Duration.ofSeconds(0))
                //指定watermark事件时间字段
                .withTimestampAssigner(new SerializableTimestampAssigner<Tuple3<String, Double, Integer>>() {
                    @Override
                    public long extractTimestamp(Tuple3<String, Double, Integer> element, long recordTimestamp) {
                         return element.f2;
                    }
                });
        // 给 流1 设置水位线
        SingleOutputStreamOperator<Tuple3<String, Double, Integer>> soso1 = dss1.assignTimestampsAndWatermarks(wsOfDss1);

        // 定义 流2 的水位线
        WatermarkStrategy<Tuple3<String, Integer, Integer>> wsOfDss2 = WatermarkStrategy
                /*
                 设置watermark最大迟到时间
                 这里为了简单设置为0
                 必须设置泛型,否则报错
                 */
//                .<Tuple3<String, Integer,Integer>>forMonotonousTimestamps()
                .<Tuple3<String, Integer,Integer>>forBoundedOutOfOrderness(Duration.ofSeconds(0))
                //指定watermark事件时间字段
                .withTimestampAssigner( (data,timestamp) -> data.f2);
        // 给 流2 设置水位线
        SingleOutputStreamOperator<Tuple3<String, Integer, Integer>> soso2 = dss2.assignTimestampsAndWatermarks(wsOfDss2);

        // 将两个流 join
        DataStream<String> apply = soso1
                .join(soso2)
                .where(data -> data.f0)
                .equalTo(data -> data.f0)
                .window(TumblingEventTimeWindows.of(Time.seconds(5)))
                .apply(new JoinFunction<Tuple3<String, Double, Integer>, Tuple3<String, Integer, Integer>, String>() {
                    /*
                    返回数据格式:拼装后的字符串
                     */
                    @Override
                    public String join(Tuple3<String, Double, Integer> first, Tuple3<String, Integer, Integer> second) throws Exception {
                        return first+"====="+second;
                    }
                });

        apply.print();
        env.execute();
    }

}
执行结果
(a,36.1,1000)=====(a,1,3000)
(a,36.1,1000)=====(a,1,4000)
(a,26.3,2000)=====(a,1,3000)
(a,26.3,2000)=====(a,1,4000)


(b,32.2,1000)=====(b,6,3000)
(b,29.4,2000)=====(b,6,3000)
解释:
第一组结果:

第二组结果:

数据 Tuple3.of("b",7, 6000)
烟雾数据流中的数据 Tuple3.of("b",7, 6000),其时间戳是 6000,是下一个窗口的;
温度数据流中,没有下一个窗口的数据,所以没有数据与之匹配,所以不执行
完善上面案例
join后,继续处理数据,当 温度大于等于 100℃,并且 烟雾浓度 大于等于 7,就要报警
需要修改数据
为了满足报警条件,需要修改数据
// 温度传感器数据
DataStreamSource<Tuple3<String, Double,Integer>> dss1 = env.fromElements(
        Tuple3.of("a",136.1, 1000), // 第一个元素表示传感器id,第二个元素表示温度,第三个元素表示时间戳
        Tuple3.of("b",32.2, 1000),
        Tuple3.of("a",26.3, 2000),
        Tuple3.of("b",29.4, 2000)
);
// 烟雾传感器数据
DataStreamSource<Tuple3<String, Integer,Integer>> dss2 = env.fromElements(
        Tuple3.of("a",1, 3000), // 第一个元素表示传感器id,第二个元素表示烟雾浓度,第三个元素表示时间戳
        Tuple3.of("b",6, 3000),
        Tuple3.of("a",8, 4000),
        Tuple3.of("b",7, 6000)
);
join后处理代码
// 处理合并后的数据
SingleOutputStreamOperator<String> flatMap = apply.flatMap(new FlatMapFunction<Tuple3<String, Double, Integer>, String>() {
    @Override
    public void flatMap(Tuple3<String, Double, Integer> value, Collector<String> out) throws Exception {
        // 当温度大于 100 ℃,烟雾浓度大于 8 时,发出警报
        if (value.f1 >= 100 && value.f2 >= 7){
            out.collect(String.format("传感器:%s 所处位置有火情,温度:%s,烟雾浓度:%s", value.f0,value.f1,value.f2));
        }
    }
});

flatMap.print();
完整代码
package join;

import org.apache.flink.api.common.eventtime.SerializableTimestampAssigner;
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.common.functions.FlatMapFunction;
import org.apache.flink.api.common.functions.JoinFunction;
import org.apache.flink.api.java.tuple.Tuple3;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.windowing.assigners.TumblingEventTimeWindows;
import org.apache.flink.streaming.api.windowing.time.Time;
import org.apache.flink.util.Collector;

import java.time.Duration;

public class C2TumblingWindowJoin完善 {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        // 温度传感器数据
        DataStreamSource<Tuple3<String, Double,Integer>> dss1 = env.fromElements(
                Tuple3.of("a",136.1, 1000), // 第一个元素表示传感器id,第二个元素表示温度,第三个元素表示时间戳
                Tuple3.of("b",32.2, 1000),
                Tuple3.of("a",26.3, 2000),
                Tuple3.of("b",29.4, 2000)
        );
        // 烟雾传感器数据
        DataStreamSource<Tuple3<String, Integer,Integer>> dss2 = env.fromElements(
                Tuple3.of("a",1, 3000), // 第一个元素表示传感器id,第二个元素表示烟雾浓度,第三个元素表示时间戳
                Tuple3.of("b",6, 3000),
                Tuple3.of("a",8, 4000),
                Tuple3.of("b",7, 6000)
        );

        // 定义 流1 的水位线
        WatermarkStrategy<Tuple3<String, Double, Integer>> wsOfDss1 = WatermarkStrategy
                /*
                 设置watermark最大迟到时间
                 这里为了简单设置为0
                 必须设置泛型,否则报错
                 */
                .<Tuple3<String, Double,Integer>>forBoundedOutOfOrderness(Duration.ofSeconds(0))
                //指定watermark事件时间字段
                .withTimestampAssigner(new SerializableTimestampAssigner<Tuple3<String, Double, Integer>>() {
                    @Override
                    public long extractTimestamp(Tuple3<String, Double, Integer> element, long recordTimestamp) {
                         return element.f2;
                    }
                });
        // 给 流1 设置水位线
        SingleOutputStreamOperator<Tuple3<String, Double, Integer>> soso1 = dss1.assignTimestampsAndWatermarks(wsOfDss1);

        // 定义 流2 的水位线
        // 给 流2 设置水位线
        SingleOutputStreamOperator<Tuple3<String, Integer, Integer>> soso2 = dss2.assignTimestampsAndWatermarks(WatermarkStrategy
                /*
                 设置watermark最大迟到时间
                 这里为了简单设置为0
                 必须设置泛型,否则报错
                 */
                .<Tuple3<String, Integer,Integer>>forBoundedOutOfOrderness(Duration.ofSeconds(0))
                //指定watermark事件时间字段
                .withTimestampAssigner( (data,timestamp) -> data.f2));

        // 将两个流 join
        DataStream<Tuple3<String, Double, Integer>> apply = soso1
                .join(soso2)
                .where(data -> data.f0)
                .equalTo(data -> data.f0)
                .window(TumblingEventTimeWindows.of(Time.seconds(5)))
                .apply(new JoinFunction<Tuple3<String, Double, Integer>, Tuple3<String, Integer, Integer>, Tuple3<String, Double, Integer>>() {
                    /*
                    返回数据格式:
                    第一个元素:group id
                    第二个元素:温度
                    第三个元素:烟雾浓度
                     */
                    @Override
                    public Tuple3<String, Double, Integer> join(Tuple3<String, Double, Integer> first, Tuple3<String, Integer, Integer> second) throws Exception {
                        return Tuple3.of(first.f0,first.f1,second.f1);
                    }
                });

        // 处理合并后的数据
        SingleOutputStreamOperator<String> flatMap = apply.flatMap(new FlatMapFunction<Tuple3<String, Double, Integer>, String>() {
            @Override
            public void flatMap(Tuple3<String, Double, Integer> value, Collector<String> out) throws Exception {
                // 当温度大于 100 ℃,烟雾浓度大于 8 时,发出警报
                if (value.f1 >= 100 && value.f2 >= 7){
                    out.collect(String.format("传感器:%s 所处位置有火情,温度:%s,烟雾浓度:%s", value.f0,value.f1,value.f2));
                }
            }
        });

        apply.print("apply::");
        flatMap.print("flatMap::");
        env.execute();
    }

}
执行结果:
apply::> (a,136.1,1)
flatMap::> 传感器:a 所处位置有火情,温度:136.1,烟雾浓度:8
apply::> (a,136.1,8)
apply::> (a,26.3,1)
apply::> (a,26.3,8)
apply::> (b,32.2,6)
apply::> (b,29.4,6)
参考:
https://cloud.tencent.com/developer/article/1880473
https://www.cnblogs.com/wdh01/p/16650173.html