说明
window join 稍微复杂麻烦,interval join相对逻辑简单,一般用 interval join 的情况比较多。
interval join 相当于 SQL 中的 inner join,如:
select t.id,t.name,s.id,s.name from teaher t inner join student s on t.id = s.teacher_id
官网
https://nightlies.apache.org/flink/flink-docs-release-1.13/zh/docs/dev/datastream/operators/joining/
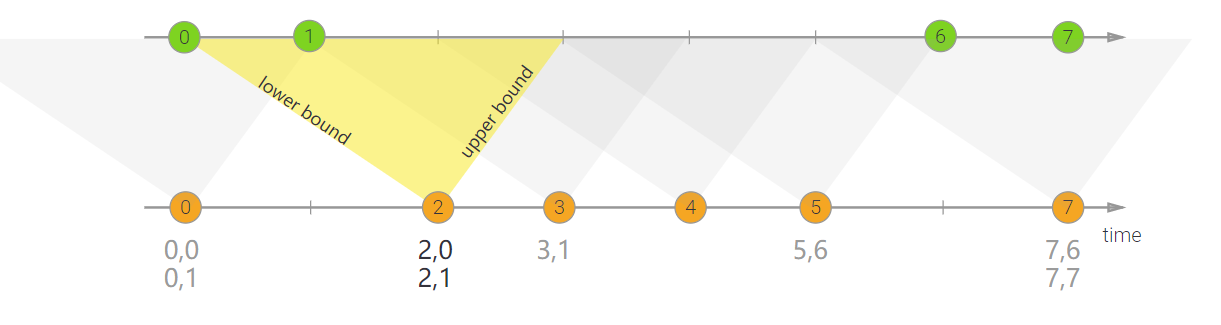
橙色流的每一个元素,都会和 绿色流的 一定时间(事件时间)范围 的元素进行JOIN。
提示: 时间范围的 上界 和 下界 可以是 负数,也可以是 正数
代码
DataStream<Integer> orangeStream = ...
DataStream<Integer> greenStream = ...

orangeStream
    .keyBy(<KeySelector>)
    .intervalJoin(greenStream.keyBy(<KeySelector>))
    .between(Time.milliseconds(-2), Time.milliseconds(1))
    .process (new ProcessJoinFunction<Integer, Integer, String(){

        @Override
        public void processElement(Integer left, Integer right, Context ctx, Collector<String> out) {
            out.collect(first + "," + second);
        }
    });
处理流程

两条流的数据,做
left.intervalJoin(right),设置时间范围left流的每一个元素,都会和 right流的 时间(事件时间)范围 的元素进行联结
然后进行遍历数据,形成 笛卡尔积,
process()方法处理这些数据
没有匹配的数据如何处理?
SQL
由于 窗口 join,类似 SQL join,如下:
select t.id,t.name,s.id,s.name from teaher t inner join student s on t.id = s.teacher_id
在 SQL 中,查询出来的数据,一定在两个表中 t.id 和 s.teacher_id 都对应匹配,只要 对应匹配不上,就查询不到
interval join
同理 SQL,如上图,数据 2 , 01:01:32 ,就没有 对应匹配 的数据,直接丢弃,不会执行
应用场景
打开 App 会收到广告,用户有时会点击展现的广告视频。
形成两条数据流:
- 广告展现日志
- 客户端点击日志
这两条数据流,需进行实时 Join,将 Join 结果,做判断:广告展现 10 秒钟 以后的点击,被认为是 有效点击(广告展现几秒后就点击了,可能是误触,或者恶意点击)
api
提示:
- 只支持事件时间
- 只支持
inner join
调用方式如下:
input1.keyBy(<KeySelector>)  // 流1 指定 key分组
  .intervalJoin(input2.keyBy(<KeySelector>)) // 流2 指定 key分组
  .between(<lower-bound>, <upper-bound>)
  .process ()
解释:
.keyBy(...):参数是键选择器(KeySelector),用来指定第一条流中的key.intervalJoin(...):相当于上面 SQL 中的from teaher t inner join student s。参数是 经过keyBy()的流2.between(Time lowerBound, Time upperBound):相对于 input1 的上下界,可为正数、负数.process(...):处理匹配的数据- 传入
ProcessJoinFunction:使用时需要实现内部的.processElement()方法。这个方法有两个参数:分别表示两条流中成对匹配的 数据。每有一对匹配数据,就调用该方法进行计算处理
- 传入
ProcessJoinFunction 源码
public abstract class ProcessJoinFunction<IN1, IN2, OUT> extends AbstractRichFunction {

    private static final long serialVersionUID = -2444626938039012398L;

    /**
     * 处理 join后的 数据对
     * @param left         左侧流中的数据
     * @param right        右侧流中的数据
     * @param ctx          上下文
     * @param out          收集器
     * @throws Exception   This function may throw exceptions which cause the streaming program to
     *                        fail and go in recovery mode.
     */
    public abstract void processElement(IN1 left, IN2 right, Context ctx, Collector<OUT> out) throws Exception;

    /**
     * 上下文
     */
    public abstract class Context {

        public abstract long getLeftTimestamp();

        public abstract long getRightTimestamp();

        public abstract long getTimestamp();

        public abstract <X> void output(OutputTag<X> outputTag, X value);
    }
}
设置 watermark
也要设置 watermark
案例
广告案例,kafka有两个主题:一个是 advert_log,一个是 click_log,flink程序连接这两个主题,并执行 join()
app 展示广告,发送到 advert_log 主题中,点击广告的日志发送到 click_log 主题中,将两条流中数据合并起来,按照广告 id 分组,如果点击时间在 广告展现时间的 10 秒后,60 秒之前,就认为是有效点击
广告 数据格式:
Tuple3.of("1","001","2022-01-01 01:00:00")
解释
- 第一个元素:广告 id。同一个广告,id相同
- 第二个元素:本次展现广告的 id。
- 第三个元素:事件时间
根据广告 id 分组带来的问题
同一个广告,本次展示的 id,也不相同,防止匹配错误
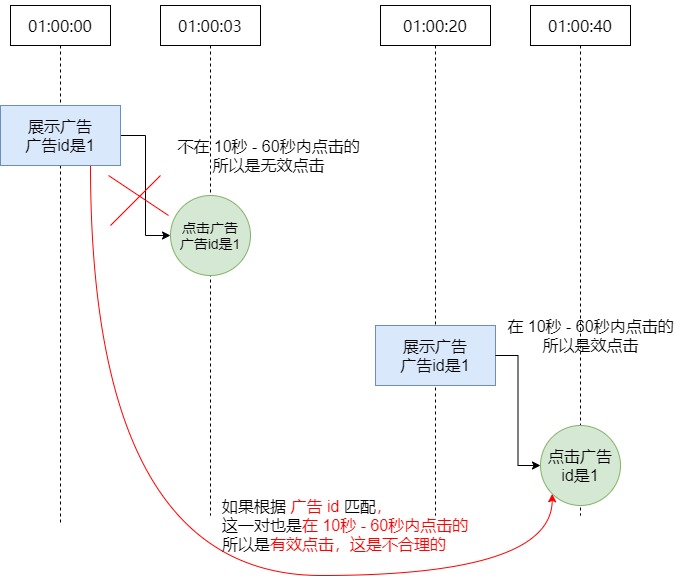
如果根据 广告 id分组,会发生下面情况:
第一次展示广告,用户在3秒后点击,是无效点击
第二次展示广告(与第一次是同一个广告),用户在 第20秒点击,是有效点击
但是:第一次展示广告 与第二次展示广告,是同一个广告,所以 广告id相同,点击时间也在
10秒 - 60秒,导致 第一次展示广告,与第二次点击匹配上了,如下图:
解决:根据 本次展现广告 id 分组
本次展示广告的 id,同一个广告,每次展示时,此 id 也不相同
根据 本次展示广告的 id 分组,就可以解决上面问题
点击广告 数据格式:
Tuple3.of("1","001","2022-01-01 01:00:03")
解释
- 第一个元素:广告 id
- 第二个元素:本次展现广告的 id
- 第三个元素:事件时间
join后的 数据格式:
这里为了演示,只做简单处理
(1,003,2022-01-01 01:00:20)===(1,003,2022-01-01 01:00:40)
解释:将第一个元素 和 第二个元素 拼成字符串
java 代码(演示)
这里为了演示,没有使用 kafka,直接生成模拟数据,只是将 join 后数据 拼成字符串,并打印
package join;

import org.apache.flink.api.common.eventtime.SerializableTimestampAssigner;
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.java.tuple.Tuple3;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.co.ProcessJoinFunction;
import org.apache.flink.streaming.api.windowing.time.Time;
import org.apache.flink.util.Collector;

import java.text.ParseException;
import java.text.SimpleDateFormat;
import java.time.Duration;
import java.util.Date;

public class C4IntervalJoin {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        // 温度传感器数据
        DataStreamSource<Tuple3<String,String,String>> dss1 = env.fromElements(
                Tuple3.of("1","001","2022-01-01 01:00:00"), // 第一个元素表示广告id,第二个元素表示显示广告时间
                Tuple3.of("2","002","2022-01-01 01:00:10"),
                Tuple3.of("1","003","2022-01-01 01:00:20"),
                Tuple3.of("2","004","2022-01-01 01:00:30")
        );
        // 烟雾传感器数据
        DataStreamSource<Tuple3<String,String,String>> dss2 = env.fromElements(
                Tuple3.of("1","001","2022-01-01 01:00:03"), // 第一个元素表示广告id,第二个元素表示点击广告时间
                Tuple3.of("2","002","2022-01-01 01:00:21"),
                Tuple3.of("1","003","2022-01-01 01:00:40"),
                Tuple3.of("2","004","2022-01-01 01:01:32")
        );

        // 定义 流1 的水位线
        WatermarkStrategy<Tuple3<String,String,String>> wsOfDss1 = WatermarkStrategy
                /*
                 设置watermark最大迟到时间
                 这里为了简单设置为0
                 必须设置泛型,否则报错
                 */
                .<Tuple3<String,String,String>>forBoundedOutOfOrderness(Duration.ofSeconds(0))
                //指定watermark事件时间字段
                .withTimestampAssigner(new SerializableTimestampAssigner<Tuple3<String,String,String>>() {
                    @Override
                    public long extractTimestamp(Tuple3<String,String,String> element, long recordTimestamp) {
                        SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss");
                        long timestamp = 0;
                        try {
                            Date date = sdf.parse(element.f2);
                            timestamp = date.getTime();
                        } catch (ParseException e) {
                            e.printStackTrace();
                        }
                        return timestamp;
                    }
                });
        // 给 流1 设置水位线
        SingleOutputStreamOperator<Tuple3<String,String,String>> soso1 = dss1.assignTimestampsAndWatermarks(wsOfDss1);

        // 定义 流2 的水位线
        // 给 流2 设置水位线
        SingleOutputStreamOperator<Tuple3<String,String,String>> soso2 = dss2.assignTimestampsAndWatermarks(WatermarkStrategy
                /*
                 设置watermark最大迟到时间
                 这里为了简单设置为0
                 必须设置泛型,否则报错
                 */
                .<Tuple3<String,String,String>>forBoundedOutOfOrderness(Duration.ofSeconds(0))
                //指定watermark事件时间字段
                .withTimestampAssigner(new SerializableTimestampAssigner<Tuple3<String,String,String>>() {
                    @Override
                    public long extractTimestamp(Tuple3<String,String,String> element, long recordTimestamp) {
                        SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss");
                        long timestamp = 0;
                        try {
                            Date date = sdf.parse(element.f2);
                            timestamp = date.getTime();
                        } catch (ParseException e) {
                            e.printStackTrace();
                        }
                        return timestamp;
                    }
                }));

        // 将两个流 join
        DataStream<String> apply = soso1
                .keyBy( data -> data.f1)
                .intervalJoin(soso2.keyBy( data -> data.f1))
                .between(Time.seconds(10),Time.seconds(60))
                .process(new ProcessJoinFunction<Tuple3<String,String,String>, Tuple3<String,String,String>, String>() {
                    @Override
                    public void processElement(Tuple3<String,String,String> left, Tuple3<String,String,String> right, Context ctx, Collector<String> out) throws Exception {
                        out.collect(left+"==="+right);
                    }
                });

        apply.print();
        env.execute();
    }

}
执行结果
(2,002,2022-01-01 01:00:10)===(2,002,2022-01-01 01:00:21)
(1,003,2022-01-01 01:00:20)===(1,003,2022-01-01 01:00:40)
根据 广告id 分组
根据 广告id 分组,会导致数据匹配错误
关键代码
// 将两个流 join
DataStream<String> apply = soso1
        .keyBy( data -> data.f0)
        .intervalJoin(soso2.keyBy( data -> data.f0))
        .between(Time.seconds(10),Time.seconds(60))
        .process(new ProcessJoinFunction<Tuple3<String,String,String>, Tuple3<String,String,String>, String>() {
            @Override
            public void processElement(Tuple3<String,String,String> left, Tuple3<String,String,String> right, Context ctx, Collector<String> out) throws Exception {
                out.collect(left+"==="+right);
            }
        });
完整代码
package join;

import org.apache.flink.api.common.eventtime.SerializableTimestampAssigner;
import org.apache.flink.api.common.eventtime.WatermarkStrategy;
import org.apache.flink.api.java.tuple.Tuple3;
import org.apache.flink.streaming.api.datastream.DataStream;
import org.apache.flink.streaming.api.datastream.DataStreamSource;
import org.apache.flink.streaming.api.datastream.SingleOutputStreamOperator;
import org.apache.flink.streaming.api.environment.StreamExecutionEnvironment;
import org.apache.flink.streaming.api.functions.co.ProcessJoinFunction;
import org.apache.flink.streaming.api.windowing.time.Time;
import org.apache.flink.util.Collector;

import java.text.ParseException;
import java.text.SimpleDateFormat;
import java.time.Duration;
import java.util.Date;

/**
 * 根据广告 id 分组,匹配错误
 */
public class C4IntervalJoin广告点击错误匹配 {

    public static void main(String[] args) throws Exception {
        StreamExecutionEnvironment env = StreamExecutionEnvironment.getExecutionEnvironment();
        env.setParallelism(1);

        // 温度传感器数据
        DataStreamSource<Tuple3<String,String,String>> dss1 = env.fromElements(
                Tuple3.of("1","001","2022-01-01 01:00:00"), // 第一个元素表示广告id,第二个元素表示显示广告时间
                Tuple3.of("2","002","2022-01-01 01:00:10"),
                Tuple3.of("1","003","2022-01-01 01:00:20"),
                Tuple3.of("2","004","2022-01-01 01:00:30")
        );
        // 烟雾传感器数据
        DataStreamSource<Tuple3<String,String,String>> dss2 = env.fromElements(
                Tuple3.of("1","001","2022-01-01 01:00:03"), // 第一个元素表示广告id,第二个元素表示点击广告时间
                Tuple3.of("2","002","2022-01-01 01:00:21"),
                Tuple3.of("1","003","2022-01-01 01:00:40"),
                Tuple3.of("2","004","2022-01-01 01:01:32")
        );

        // 定义 流1 的水位线
        WatermarkStrategy<Tuple3<String,String,String>> wsOfDss1 = WatermarkStrategy
                /*
                 设置watermark最大迟到时间
                 这里为了简单设置为0
                 必须设置泛型,否则报错
                 */
                .<Tuple3<String,String,String>>forBoundedOutOfOrderness(Duration.ofSeconds(0))
                //指定watermark事件时间字段
                .withTimestampAssigner(new SerializableTimestampAssigner<Tuple3<String,String,String>>() {
                    @Override
                    public long extractTimestamp(Tuple3<String,String,String> element, long recordTimestamp) {
                        SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss");
                        long timestamp = 0;
                        try {
                            Date date = sdf.parse(element.f2);
                            timestamp = date.getTime();
                        } catch (ParseException e) {
                            e.printStackTrace();
                        }
                        return timestamp;
                    }
                });
        // 给 流1 设置水位线
        SingleOutputStreamOperator<Tuple3<String,String,String>> soso1 = dss1.assignTimestampsAndWatermarks(wsOfDss1);

        // 定义 流2 的水位线
        // 给 流2 设置水位线
        SingleOutputStreamOperator<Tuple3<String,String,String>> soso2 = dss2.assignTimestampsAndWatermarks(WatermarkStrategy
                /*
                 设置watermark最大迟到时间
                 这里为了简单设置为0
                 必须设置泛型,否则报错
                 */
                .<Tuple3<String,String,String>>forBoundedOutOfOrderness(Duration.ofSeconds(0))
                //指定watermark事件时间字段
                .withTimestampAssigner(new SerializableTimestampAssigner<Tuple3<String,String,String>>() {
                    @Override
                    public long extractTimestamp(Tuple3<String,String,String> element, long recordTimestamp) {
                        SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss");
                        long timestamp = 0;
                        try {
                            Date date = sdf.parse(element.f2);
                            timestamp = date.getTime();
                        } catch (ParseException e) {
                            e.printStackTrace();
                        }
                        return timestamp;
                    }
                }));

        // 将两个流 join
        DataStream<String> apply = soso1
                .keyBy( data -> data.f0)
                .intervalJoin(soso2.keyBy( data -> data.f0))
                .between(Time.seconds(10),Time.seconds(60))
                .process(new ProcessJoinFunction<Tuple3<String,String,String>, Tuple3<String,String,String>, String>() {
                    @Override
                    public void processElement(Tuple3<String,String,String> left, Tuple3<String,String,String> right, Context ctx, Collector<String> out) throws Exception {
                        out.collect(left+"==="+right);
                    }
                });

        apply.print();
        env.execute();
    }

}
执行结果
(2,002,2022-01-01 01:00:10)===(2,002,2022-01-01 01:00:21)
(1,001,2022-01-01 01:00:00)===(1,003,2022-01-01 01:00:40)  匹配错误
(1,003,2022-01-01 01:00:20)===(1,003,2022-01-01 01:00:40)
参考:
https://www.infoq.cn/article/sEMcN3uK-3jk9EBCiUuS
https://blog.csdn.net/winterking3/article/details/115375119
https://zhuanlan.zhihu.com/p/340560908
https://blog.csdn.net/andyonlines/article/details/108173259