Toggle navigation
  • 首页
  • 所有教程
  • 导航
  • Python
  • 人工智能
  • JAVA
  • 数据库
  • 前端
  • linux
  • 大数据
  • 技术文章
  • 更多
    • C/C++
    • 软件
    • 大杂烩
    • 硬件

spark3.0教程:sc.textFile源码分析、默认并行度(本地开发环境)

作者:马育民 • 2022-11-16 19:51 • 阅读:10125

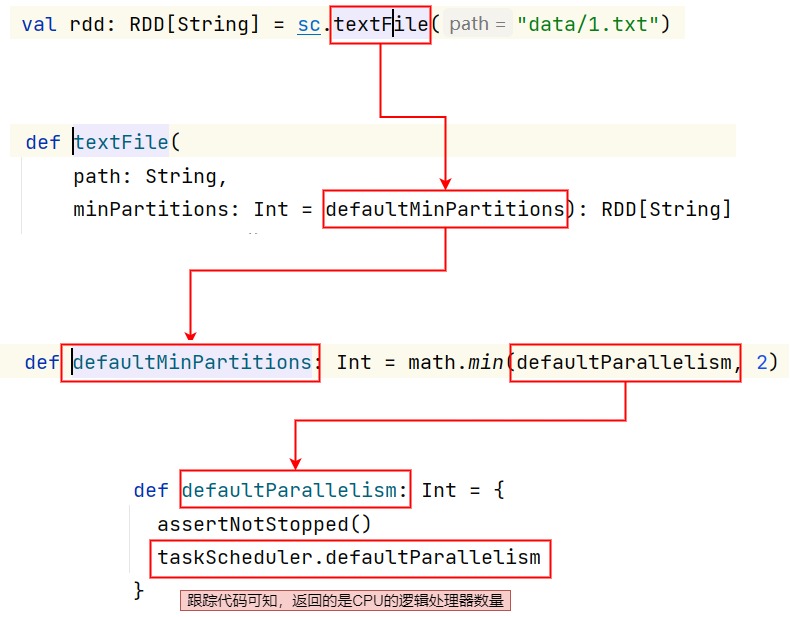
源码执行流程

通过源码分析可知,如果 不设置并行度,本地开发环境,如果 CPU逻辑处理器数量大于 2,就取值 2

所以,在开发环境中,并行度是 2,生成的文件数量也是 2


原文出处:/show_1IX4QQYpwoYT.html
搜索

相关文章

hive 设置内存,否则批量执行SQL会因为内存溢出崩溃
spark3.0教程-SparkSQL:连接MySQL,写入数据,打包后,部署到yarn运行(依赖第三方包)
2026年大数据平台操作系统选型指南:从CentOS替代到信创适配
2026年大数据部署方式:容器主导,混合部署成主流
spark 读取 hive 报错:Permission denied: user=xxx, access=EXECUTE, inode="/tmp":root:supergroup:drwx
不懂数据湖项目?用普通人能听懂的话讲明白
Atlas2.1.0-启动和停止(集群+单机)
flink1.12.x:per-job cluster模式(yarn-cluster)启动程序,按ctrl+c断开客户端后关闭flink任务
flink1.12.x flink list列出 Flink 集群中正在运行的任务
hadoop3.x集群部署-VMware17 克隆虚拟机
吉ICP备15003043号