执行流程
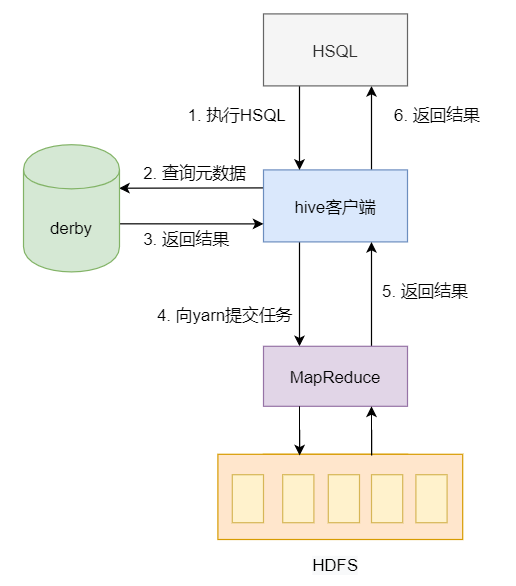
启动hadoop
需要启动 NameNode 、 DataNode、yarn
启动 NameNode 和 DataNode
登录 hadoop1 执行下面命令:
start-dfs.sh
启动 yarn
hive将任务提交给 yarn,所以需要启动yarn
登录 hadoop2 执行下面命令:
start-yarn.sh
启动 hive 客户端
derby 数据库
注意: 使用 derby 数据库 存储元数据,必须在 /program/hive-3.1.2 目录下执行,因为在derby 元数据存储在该目录下
如果在其他位置执行 hive ,会报错
hive
看到下面界面表示启动成功:
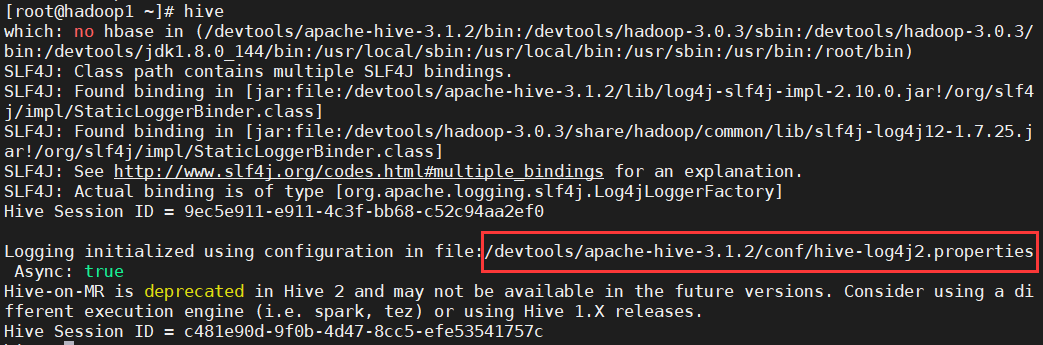
红框中 加载之前配置的日志文件
如下提示信息:
Hive-on-MR is deprecated in Hive 2 and may not be available in the future versions. Consider using a different execution engine (i.e. spark, tez) or using Hive 1.X releases.
意思是:在 hive2 版本中, 基于 mapreduce 的hive是过时了,推荐 基于 spark、tez 上部署 hive2
退出
exit、quit、ctrl+c