介绍
Parquet 是面向分析型业务的 列式存储 格式,由 Twitter 和 Cloudera 合作开发,2015 年 5 月从 Apache 的孵化器里毕业成为 Apache 顶级项目
特点
与TEXT、JSON、CSV等文件格式相比,它有三个核心特征:
- 列式存储。
数据按列分开存储。由于同一列的数据类型是一样的,可以使用更高效的压缩编码进一步节约存储空间。 - 自带Schema
- 具备Predicate Filter特性
文件结构
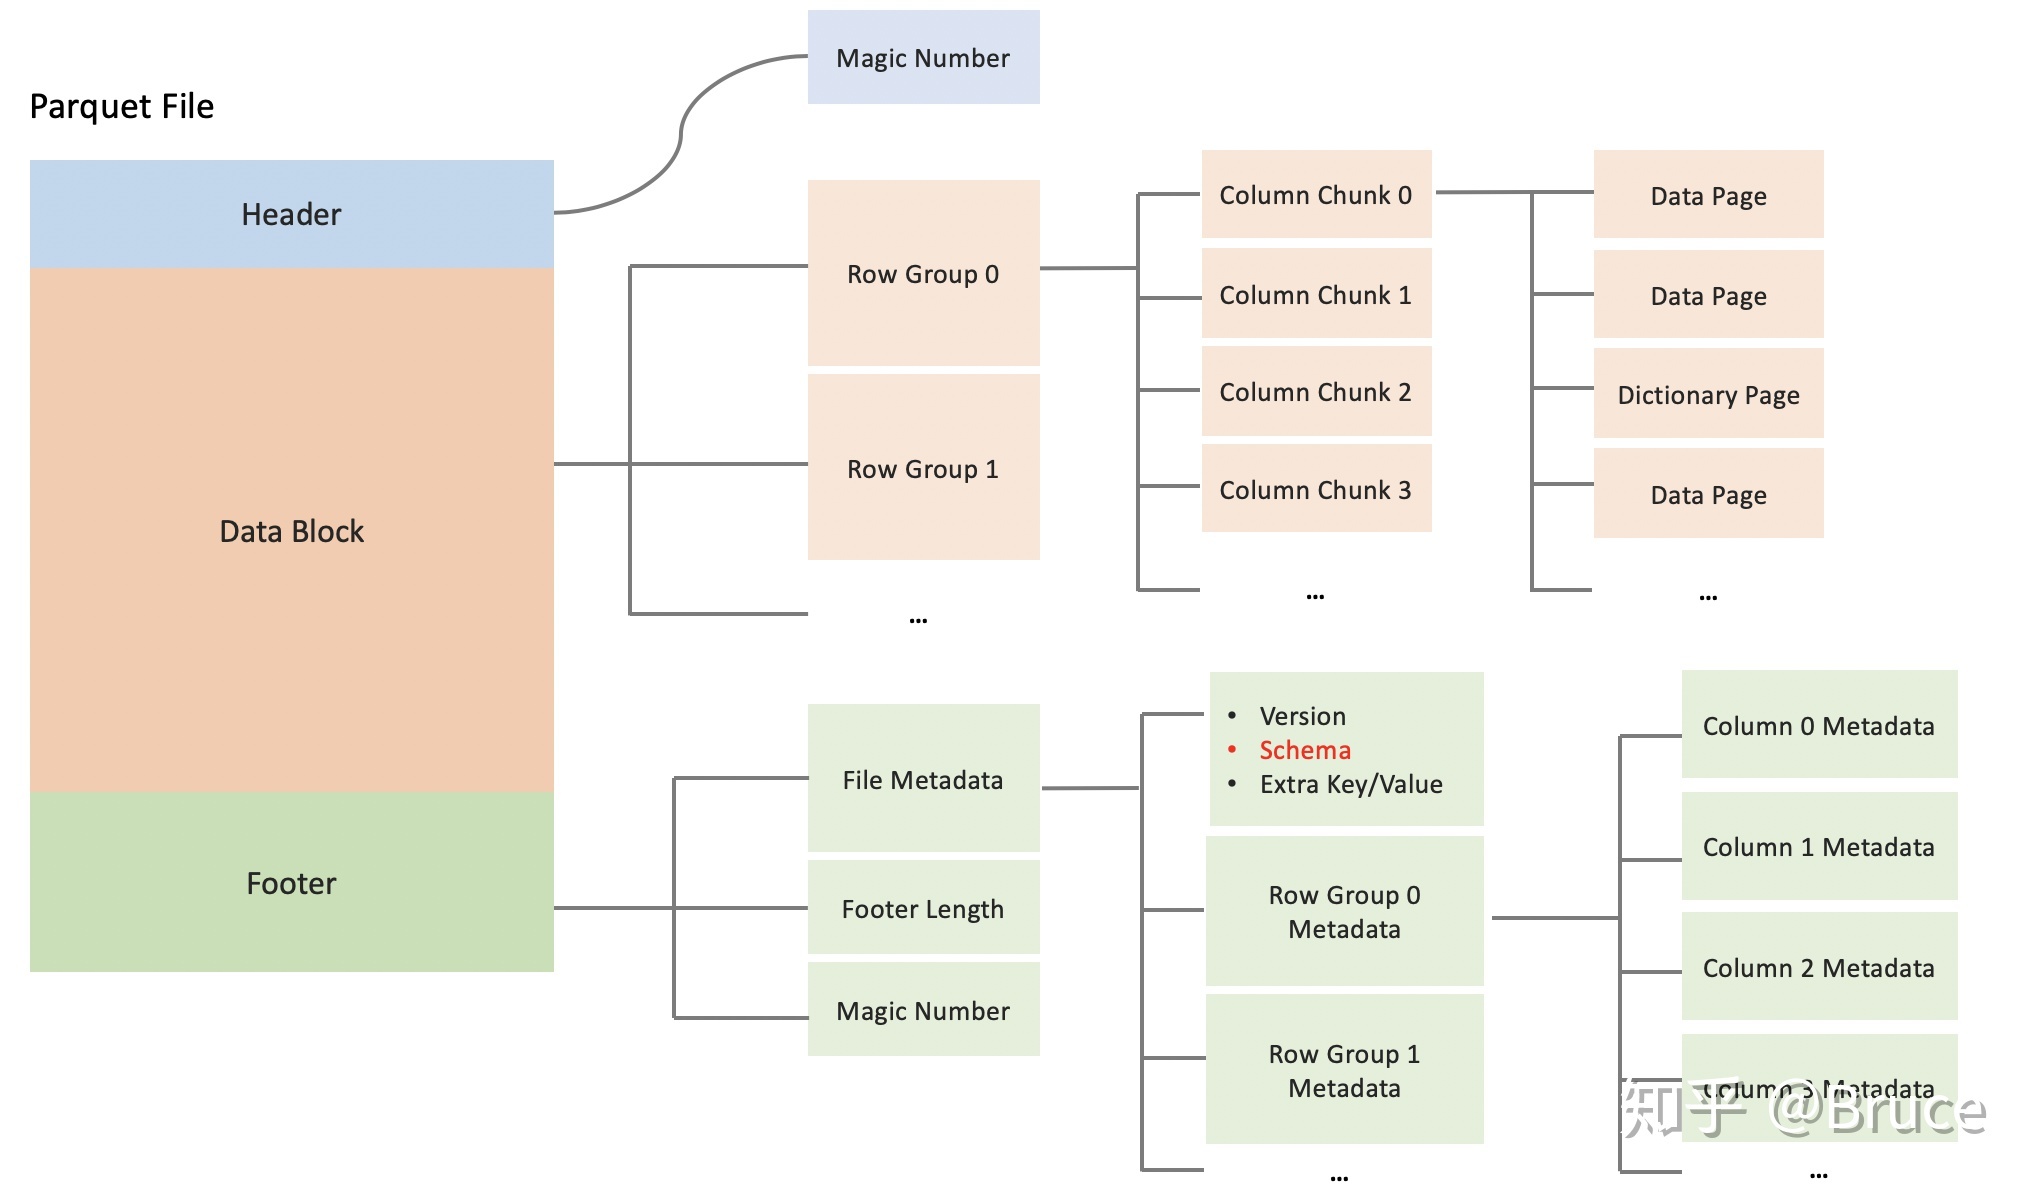
一个Parquet文件的内容由 Header、Data Block 和 Footer 三部分组成。
Data Block是具体存放数据的区域,由多个Row Group组成,每个Row Group包含了一批数据。
Footer部分由File Metadata、Footer Length和Magic Number三部分组成。
适配多种计算框架
Parquet 是语言无关的,而且不与任何一种数据处理框架绑定在一起,适配多种语言和组件,能够与 Parquet 配合的组件有:
查询引擎: Hive, Impala, Pig, Presto, Drill, Tajo, HAWQ, IBM Big SQL
计算框架: MapReduce, Spark, Cascading, Crunch, Scalding, Kite
数据模型: Avro, Thrift, Protocol Buffers, POJOs
文件查看工具
Parquet格式文件是二进制的,无法直接查看,需要通过下面工具来查看
parquet-tools
由官方提供,下载源码编译jar包,下载链接
采用命令行形式,通过参数来指定相关功能
java -jar ./parquet-tools-1.8.2.jar meta part-00003-c04d37ba-3de5-4f7b-addc-b6f4bc5a7ab1-c000.snappy.parquet
bigdata-file-viewer
通过GitHub下载jar包,链接
有UI可以查看数据,通过命令行启动UI
java -jar ./BigdataFileViewer-1.2-SNAPSHOT-jar-with-dependencies.jar
提示:1.3(含1.3)以上版本已经不支持 java8
idea
idea默认支持
参考:
https://zhuanlan.zhihu.com/p/111822325